点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
一、3D物体不只是一个整体,还能被模型理解为不同部件
给模型一个3D物体,如果我们只想找到椅子的扶手、汽车的车轮,或者把一个复杂的3D模型完整拆解成具有语义含义的部件,应该怎么办?
这看起来是同一个问题,实际上却对应着不同的3D分割任务。传统方法往往针对特定任务分别设计:有的方法可以根据点击分割指定区域,有的方法可以根据文本寻找目标部件,还有的方法负责把整个物体拆解成多个区域。但这些方法的任务能力并不完全一致,能够分割一个局部,不代表能够理解整个物体的部件结构;能够输出几何区域,也不代表能够给这些区域赋予准确的语义。
针对这一问题,PartLLM提出了一种统一的多模态3D部件理解框架。它不再把不同分割任务看作彼此独立的问题,而是将它们统一为由用户意图驱动的自回归语义分解(Autoregressive Semantic Decomposition):用户可以通过文本指定目标部件、通过点击发起交互式分割,也可以要求模型将整个物体拆解为不同粒度的语义部件。
工作最核心的突破,是让同一个模型统一完成文本引导分割、交互式分割和完整物体语义分解,并将生成的部件语义与具体3D几何区域对应起来。
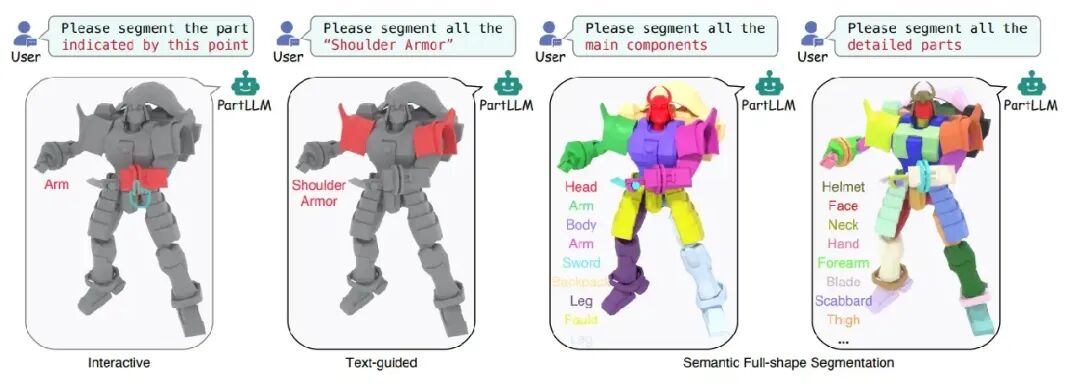 展示同一个3D物体在不同用户指令下,分别执行文本引导分割、点击交互分割,以及完整物体的粗粒度或细粒度语义拆解。
二、PartLLM如何实现统一分割?关键是先生成部件,再定位几何
PartLLM并不是简单地将语言模型与一个传统分割模块拼接起来,而是重新组织了整个3D部件分割流程:先根据物体几何和用户意图生成部件假设,再利用专门的解码器,将这些部件假设映射到具体的3D点上。
整个方法主要包含两个核心部分。
1. 3D感知多模态大模型:先判断“有什么部件”
首先,PartLLM通过点云编码器提取输入3D物体的几何特征,并将采样后的点云特征映射到多模态大语言模型的特征空间,使模型能够结合三维几何信息与用户指令进行预测。
接下来,模型以自回归方式逐步生成部件假设。每个假设不仅包含部件的语义名称,还包含一个描述其大致空间位置的3D边界框。
例如,当输入一把椅子的点云,并要求模型分割主要部件时,模型可以依次生成椅背、坐垫、扶手和椅腿等部件假设,并为相应部件提供粗略的空间定位信息。
这里有一个重要区别:传统的分割模型通常需要在既定标签体系下预测区域,而PartLLM尝试让模型根据当前物体和用户意图,动态生成需要分割的部件及其语义标签。模型不仅要判断“哪些点属于同一区域”,还要明确“这个区域是什么部件,以及它位于哪里”。
 展示点云编码、用户意图输入、3D感知多模态大模型生成部件假设,以及后续分解感知解码器生成点级分割结果的完整流程。
2. 分解感知解码器:再解决“哪些点属于哪个部件”
生成部件名称和粗略位置之后,模型还需要把这些抽象的部件假设转换为真正的3D分割结果。
PartLLM为此设计了分解感知解码器(Decomposition-aware Decoder)。它不是简单地对每个部件分别预测一个独立的二值掩码,而是将生成的多个部件假设放在同一个分解过程中,联合决定每个3D点应该归属于哪个部件,或者归入剩余的背景区域。
为什么要这样设计?
假设模型需要同时分割椅子的扶手、椅背和坐垫。如果每个部件都独立预测掩码,不同部件可能出现区域重叠、边界不一致,或者某些点被错误地分配给相邻部件等问题。
PartLLM通过联合点分配,让不同部件在同一个分解结果中共同竞争点的归属,从而减少相互重叠,并帮助模型维持部件之间更一致的边界与语义关系。
简而言之,语言模型负责提出“分哪些部件”,解码器负责确定“每个部件具体对应哪些3D点”。 两者结合,才能将语义理解转化为可以直接使用的稠密3D分割结果。
三、一个模型统一三大任务,用户意图决定分割方式
PartLLM的统一框架主要支持三类任务。
1. 文本引导分割:直接指定想找的部件
用户可以输入部件名称,让模型定位对应的3D区域。例如,输入“Wheel”寻找车轮,或者指定“Armrest”提取椅子的扶手。
与只能在固定类别集合中选择标签的方式不同,PartLLM支持通过文本查询指定部件,并能够在一次分解过程中同时处理多个目标部件。
2. 交互式分割:点击目标,恢复完整部件区域
在交互式任务中,用户通过点击3D物体上的一个点来指定目标。模型需要结合整个物体的几何结构与语义信息,推断该点对应的完整部件,而不只是简单地截取点击点附近的一小块区域。
这对细长、形状复杂,或者与相邻部件几何特征相似的区域尤其重要。点击提供了目标线索,但模型仍需要理解这个点在整个物体结构中属于什么部件。
3. 完整物体语义分解:从整体生成部件结构
用户也可以直接要求模型分割整个物体的主要部件,或者进一步生成更细粒度的部件分解。
例如,同一个角色模型既可以被拆解为头部、身体、手臂和腿部,也可以进一步细分出头盔、手部、前臂、护甲等结构。
这意味着,分割结果不必固定在唯一的粒度上,而是可以根据用户意图调整。PartLLM希望把3D分割从“输出一组区域”,推进到“按照需求生成有语义的部件结构”。
 展示模型在不同艺术创作或AI生成的3D资产上,识别语义部件并生成具有清晰边界的分割结果。
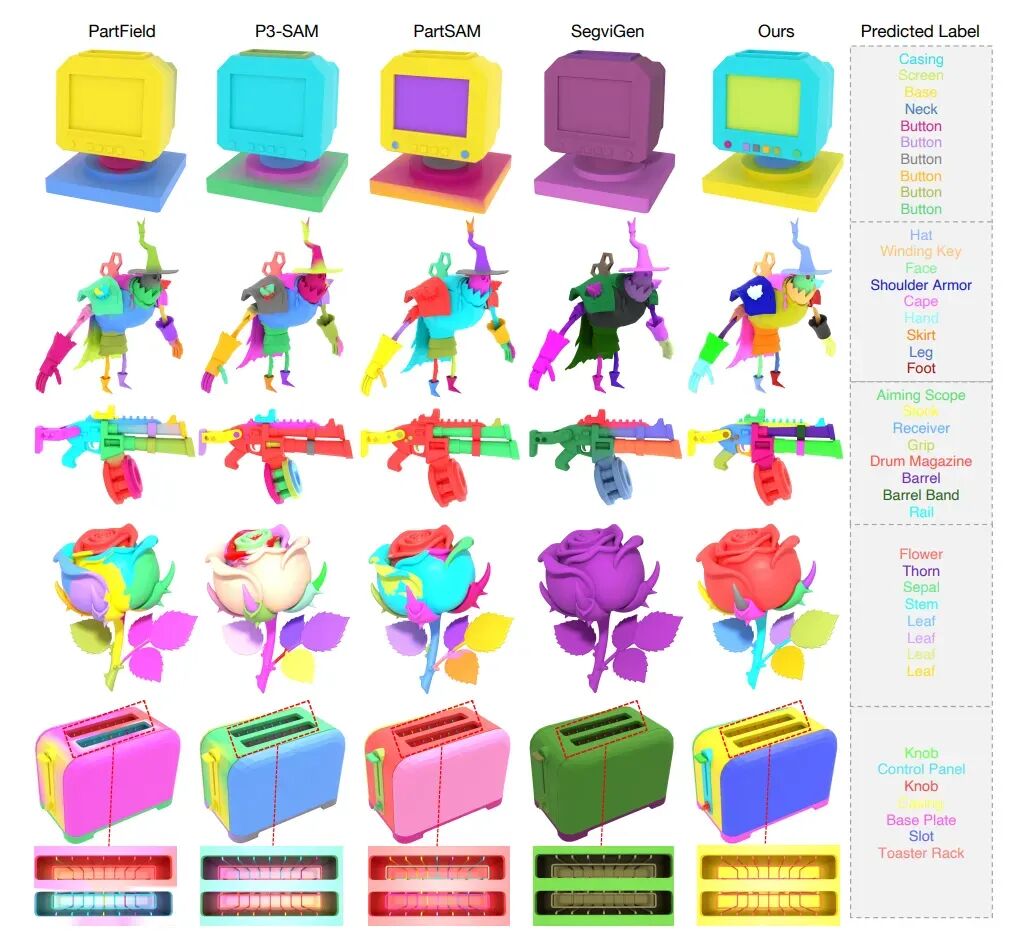 图中对比了 PartField、P3-SAM、PartSAM、SegviGen 和 PartLLM 在不同3D物体上的完整部件分割结果,涵盖显示器、人物、玩具枪、玫瑰和烤面包机等对象。不同颜色代表不同的分割部件,右侧还展示了模型预测的部件语义标签。
对比可以看出,PartLLM不仅需要将物体划分为不同区域,还要尽可能保持部件结构完整,并为分割区域赋予有意义的语义标签。
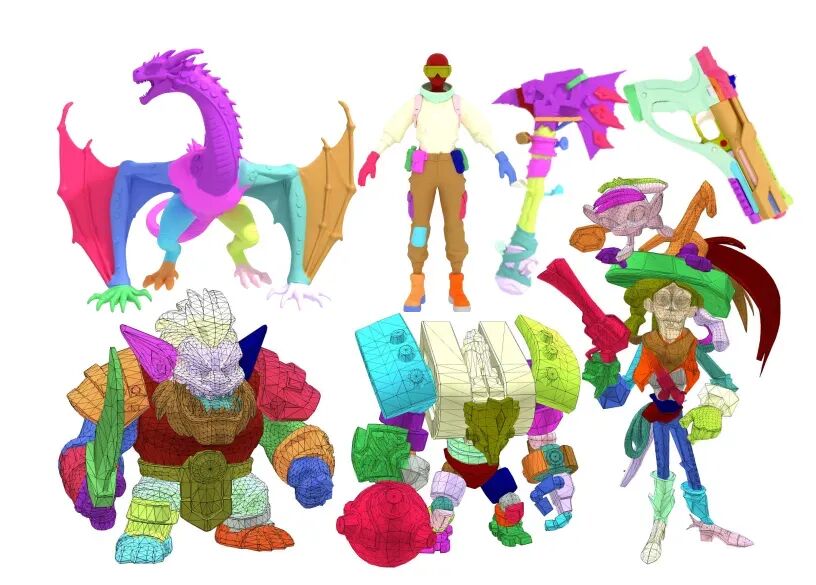 展示了 PartLLM 在不同生成方式得到的3D模型上的分割结果:第一行是基于几何的生成模型产生的高密度网格,第二行是基于自回归拓扑生成模型产生的低多边形网格。实验表明,面对几何复杂程度和网格拓扑存在差异的AI生成模型,PartLLM仍能生成具有一定语义连贯性的部件分解结果,体现了其在不同类型3D资产上的应用潜力。
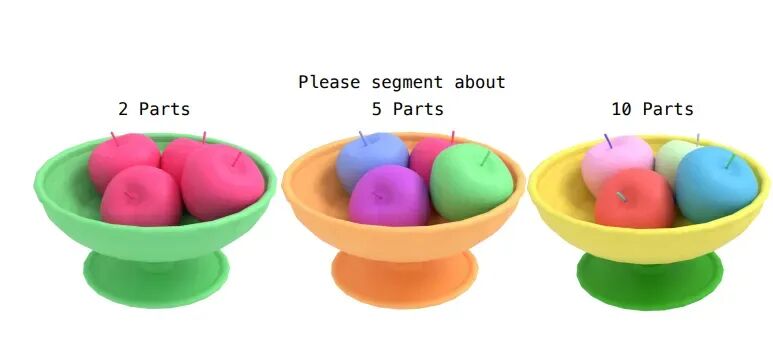 该图以同一个物体为例,分别要求模型将其拆解为2个、5个和10个部件。随着指定部件数量增加,模型会生成更加精细的部件划分,同时尽量保持部件语义的连贯性。
这体现了 PartLLM 的一个重要特点:用户不仅可以要求模型分割整个物体,还可以通过提示控制拆解的粒度,而不必完全依赖固定的分割类别或预设数量。
四、实验结果如何?文本引导分割mIoU达到86.1%
统一框架是否有效,最终还需要看实验结果。工作在多个3D部件分割基准上进行了评估,并与已有方法进行了比较。
1. 文本引导分割:多个基准上取得更高mIoU
在文本引导分割实验中,工作将PartLLM与FIND3D、PatchAlign3D和CoSMo3D等方法进行了比较。
| 86.1 | |
其中,86.1是PartLLM在3DCoMPaT200-Coarse上的文本引导分割mIoU,而不是所有数据集或任务的总体成绩。在工作报告的这四个基准设置中,PartLLM均优于表中所比较的基线方法。
更值得注意的是,在3DCoMPaT200-Fine上,PartLLM的mIoU达到80.0,而CoSMo3D为26.1。这说明在该实验设置下,PartLLM不仅能够根据文本找到指定部件,还能更好地处理细粒度部件分割。
表5:文本引导部件分割定量对比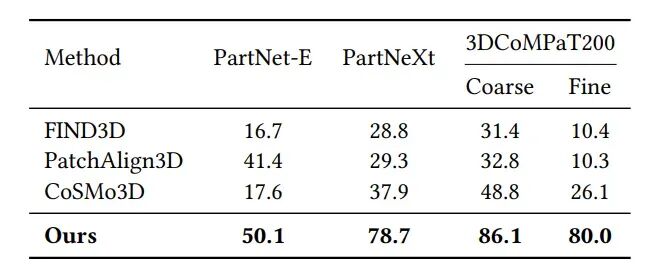
2. 完整物体分割:几何区域与部件语义一起预测
完整物体语义分解不仅需要得到合理的几何掩码,还需要让每个区域对应正确的部件语义。
工作在PartObjaverse-Tiny上的完整物体分割实验中报告,PartLLM的mask mIoU达到74.2、SA-mIoU达到63.1。SA-mIoU关注分割区域与语义标签是否同时匹配,因此能够进一步衡量模型输出的部件是否具有正确的语义身份。
在相应实验中,PartSAM的mask mIoU为42.2。需要注意的是,mask mIoU和SA-mIoU衡量的侧重点不同,不能将两者直接当作同一种指标进行比较。
表4:完整物体部件分割结果
3. 交互式分割:一个点击也需要理解完整部件
在交互式分割中,用户提供的点击点只是一个稀疏提示。模型需要根据点的位置和整个物体的几何结构,恢复对应的完整部件。
工作的实验显示,PartLLM在不同交互轮数下均表现出较强的分割能力。作者报告,在单次点击设置下,PartLLM相较最强基线最高提升10.1个mIoU百分点;在能够输出多轮交互结果的方法中,经过七次点击后,优势最高达到18.5个mIoU百分点。
这项结果说明,点击提示并不一定只能用来寻找局部邻域。结合部件语义和整体结构,模型可以尝试从一个稀疏提示中推断出更完整的目标区域,并通过后续交互进一步修正分割结果。
表6:交互式部件分割定量对比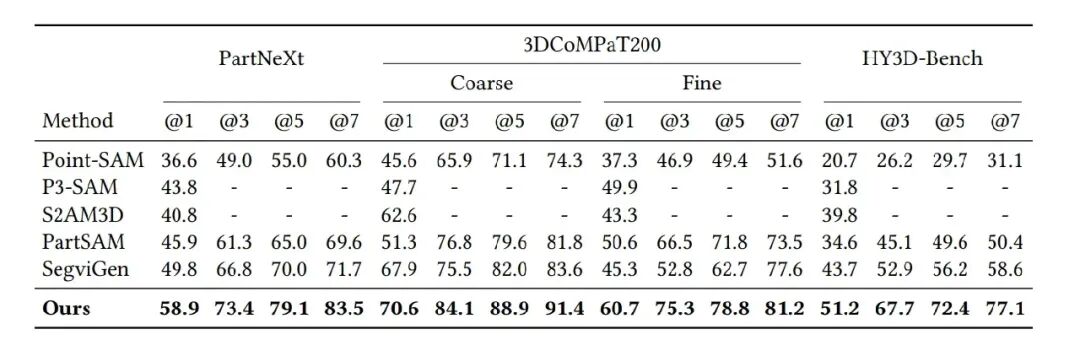
4. 真实扫描泛化:不只处理理想化的3D模型
除合成或标准化的3D资产外,工作还评估了PartLLM在真实扫描数据上的表现。
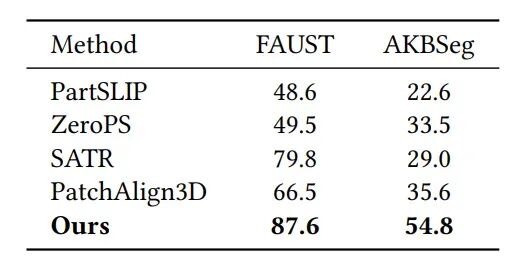
在FAUST数据集的类别无关完整物体分割实验中,PartLLM的mIoU达到72.2,高于表中比较的PartSAM、P3-SAM和SegviGen。
在真实扫描的文本引导分割实验中,PartLLM在FAUST上的mIoU为87.6,在AKBSeg上的mIoU为54.8,均高于工作所比较的基线方法。
这些实验说明,PartLLM的能力并不局限于规则、完整的合成模型。不过,真实扫描实验仍然是在特定数据集和评估协议下完成的,不能据此认为它已经能够无条件处理所有真实世界物体。
表7—表8:真实扫描场景中的分割评估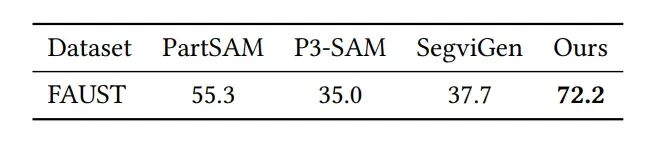
五、323K个3D形状、110万训练样本:统一任务也意味着统一数据
PartLLM的另一项重要设计,是将不同任务的训练监督整合到同一框架中。
工作使用了多个公开3D部件数据集,并利用多模态大模型为75K个获得许可的3D资产补充语义部件标注,同时加入用于类别无关几何分解的训练数据。最终,训练数据覆盖323K个独立3D形状,并构建出约1.1M个统一训练样本。
这里需要区分两个数字:323K指不同的3D形状数量,1.1M指根据不同任务模式和分解粒度构建的训练样本数量,并不代表有110万个互不重复的3D物体。
统一数据格式的意义在于,不同任务的监督信息可以共同训练同一个模型。例如,文本引导数据不仅帮助模型学习根据名称定位部件,也可能改善完整物体分解;交互式数据则为模型提供了另一种定位目标部件的监督信号。
工作的消融实验表明,逐步加入文本、交互和几何分解等训练数据后,模型在多个评估指标上获得了提升。这支持了作者的观点:不同分割任务并不一定需要各自独立的模型,它们之间可以通过统一训练框架共享部件理解能力。
表12:不同训练数据组合的消融实验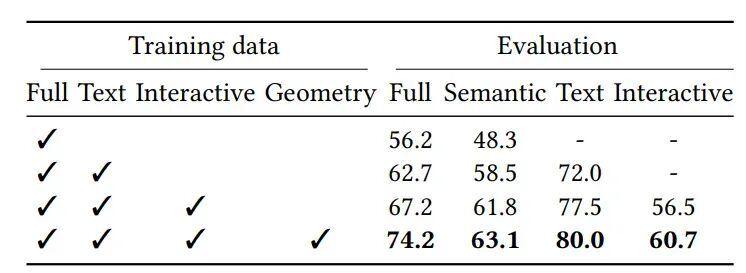
六、从3D分割到资产编辑:部件掩码可以成为操作接口
PartLLM的输出不只是用于展示的彩色分割区域。由于每个预测部件都对应具体的点级掩码,这些掩码还可以作为后续3D资产编辑的操作区域。
例如,用户可以通过文本查询或点击定位车轮,再将对应掩码用于材质替换;也可以选中某个部件,对其几何结构进行修改。
这让3D部件分割具有了更直接的应用价值:先识别部件,再围绕这个部件执行编辑操作。 对3D资产制作、模型整理和交互式内容编辑而言,这种语义化的操作接口可能比单纯输出分割结果更有意义。
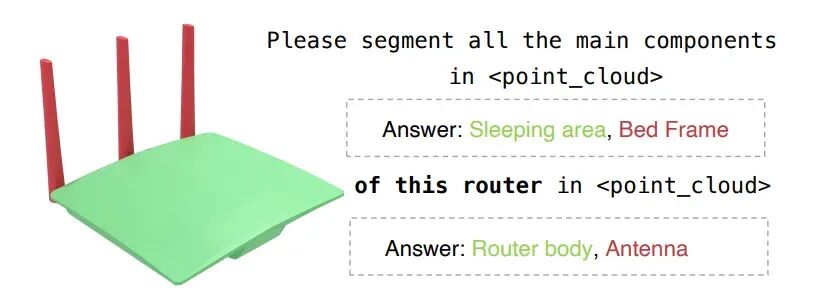
不过,工作也指出了当前方法的局限:当物体类别仅从几何形状中难以判断时,模型可能使用错误的语义先验,生成看似连贯但实际错误的部件结构。例如,将路由器误判为床,就可能在路由器几何上生成床相关的部件。向模型补充物体类别提示有助于缓解这一问题。
图13—图14:部件编辑应用与典型失败案例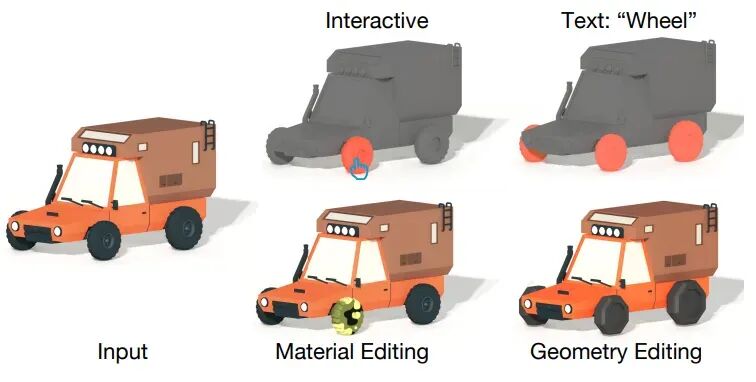
七、总结:3D分割正在从固定任务走向意图驱动的部件理解
PartLLM的价值,并不只是把文本分割、点击分割和完整物体分割放进同一个模型,而是尝试通过自回归语义分解与分解感知解码,让模型根据用户意图动态生成部件假设,并将部件语义与具体3D几何对应起来。
从实验结果来看,PartLLM在工作评估的文本引导、交互式和完整物体分割设置中均展现出竞争力;323K个形状与1.1M个训练样本组成的统一数据,也为多任务训练提供了基础。
当然,部件语义判断仍可能受到物体类别歧义的影响,真实场景中的复杂几何和开放类别也仍是值得继续研究的问题。但这项工作给出了一个清晰方向:未来的3D理解模型,不仅要知道物体的几何形状,还需要理解物体由哪些部件组成,并能够根据人的意图选择、分割和操作这些部件。
对于3D视觉而言,这意味着部件分割有望从独立的几何处理步骤,进一步成为连接自然语言、三维结构理解与资产编辑的通用接口。
工作与代码:
GitHub:https://github.com/czvvd/PartLLM 项目主页:https://czvvd.github.io/PartLLMPage/
本文仅做学术分享,如有侵权,请联系删文。
。


扫码添加微信,备注:姓名+方向+单位,邀请入群。