点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
来源:3D视觉工坊
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
太长不看版:ART 把任意端到端 VLA 模型微调成能"即插即用"调用外部工具的智能体;仅用 3 万条工具调用轨迹 + 两段式 LoRA 微调,就在 LIBERO 仿真与真实机器人上把成功率较主流基线提升约 20%。
标题:Evolve Vision-Language-Action Model into an Agent with On-the-fly Tool-use
作者:Yi Ding, Yanzhao Yu, Xili Dai, Xianbiao Qi, Peiwen Sun, Xueqian Wang, Xiangyu Yue, Jianan Wang
机构:Astribot; Tsinghua University; JuxiTech; IntelliFusion Inc.; The Chinese University of Hong Kong
论文:https://arxiv.org/abs/2608.14047

导读
视觉-语言-动作(VLA)模型近年来发展迅猛,大致可分为两条路线:模块化与端到端。模块化方法(如 RoboTool、RoboScript、RoboCodeX)把动作生成拆成若干子模块,灵活但动作表达受限;端到端方法(如 OpenVLA、ECoT、π0)用一个大模型直接输出精细动作,但遇到新场景往往需要昂贵的事后训练,且所有能力耦合在一起,微调新数据时容易灾难性遗忘。
本文把端到端 VLA 模型与智能体式工具调用(agentic tool-use)结合起来,提出 ART(Agentic Robot with Tool-use,带工具调用的智能体机器人)。ART 是一个"工具注入"框架,可微调任意 VLA 模型去调用现成的工具模块,用于底层视觉、高层可供性(affordance)以及具身能力增强。相比动作空间完全连续的原始 VLA,ART 通过工具使用降低了动作求解空间的复杂度,既提升跨任务泛化能力,又减少数据依赖。
为验证该框架"高泛化、低数据依赖"的优势,作者先构建了 3 万条工具调用轨迹与动作示范的数据集(远小于基线方法用量),再设计了一套面向困难环境下长轨迹工具推理的训练方案。实验表明,在仿真与真实世界任务(如暗光、新视角下的抓取-放置)上,ART 比主流基线成功率高出约 **20%**。
效果展示
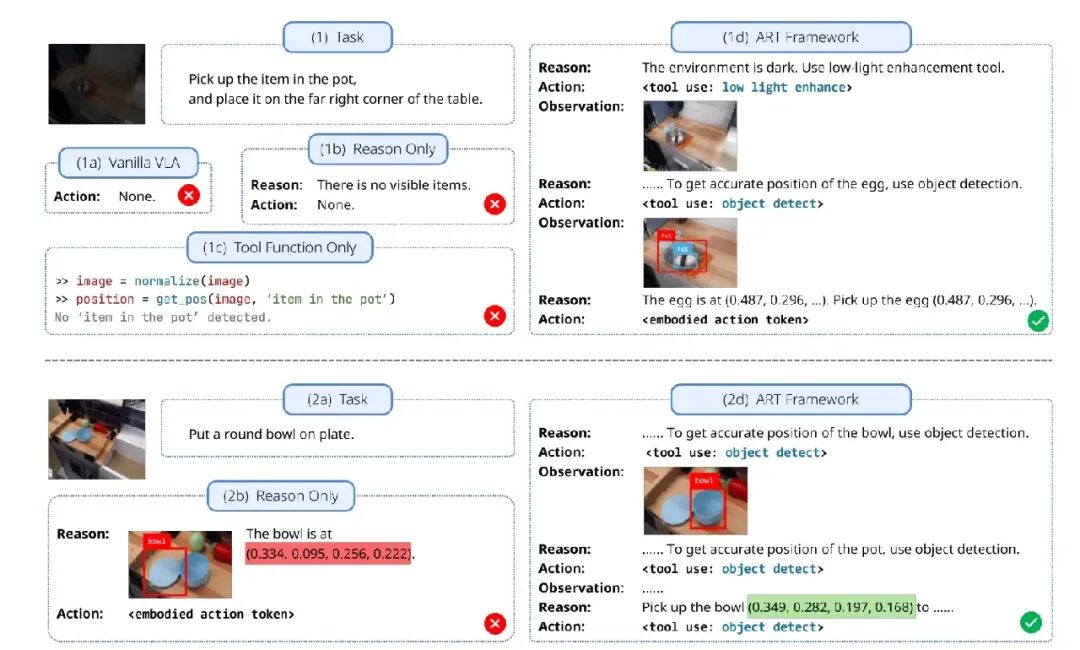
▲ 不同 VLA 范式对比:(a) 标准端到端 VLA;(b) 引入思维链(CoT)推理的 VLA;(c) 模块化机器人行为合成;(d) 本文的"带工具调用的智能体机器人(ART)"框架,将工具使用集成进端到端动作生成过程。ART 通过动态工具使用,在复杂环境(Task1)中表现出更强的适应能力,并纠正了基础模型的幻觉预测(Task2)。

▲ 实验执行轨迹展示。(a) π-FAST 与 ART 在低光照环境下的表现;(b) ART 在可供性推理任务上的表现,而由 π-FAST 控制的机器人未预测出任何动作 token,在此处保持静止。
引言
视觉-语言-动作(VLA)模型领域已取得显著进展,大致可分为两条主要发展路线:模块化与端到端。模块化方法的代表如 RoboTool 、RoboScript 、RoboCodeX ,把动作执行、目标识别 和 3D 几何 等具体功能封装成模块。相比之下,ART 直接挑战长程、多任务轨迹中的工具使用,借助工具集成的推理来解决更广泛的任务。
早期研究的核心难点在于弥合高层人类指令与机器人行为之间的鸿沟。主流研究路线把动作生成拆成模块化子任务 :在时刻 t 给定观测 o_t,模型 π 合成一系列外部模块逐步完成任务,而非直接生成动作: π: o_t ⇝ (f, f_act), f: o_t ⇝ o*_t, f_act: (o_t, o*_t) ⇝ A_t (1) 其中 f 返回中间表征(即可供性,如物体位置 与分割掩码 ),f_act 把几何位置转成机器人运动 。例如 CaP 按序调用 pick(obj) 与 place_at(pos) 完成抓取-放置。该方法把不同机器人能力打包成模块,模型可灵活调用现成工具;但它依赖大规模、带手工可供性标注的数据,而在机器人领域这类标注很难获取 ,且对高质量观测敏感,在真实噪声场景下性能骤降 。
关于多模态智能体的工具使用:大语言模型研究已展示其作为多模态智能体、借助工具解决复杂任务的能力 。智能体利用强大的语言模型生成伪代码 、脚本 或 API 列表 来顺序调用外部工具,在网页搜索 、图像编辑 、游戏 中表现优异。近期若干工作把工具使用引入端到端 VLA 框架:TIGeR 把几何计算工具融入端到端动作生成以增强空间感知与推理能力,VLA2 用网页知识检索把 VLA 泛化到未见目标。这些方法展示了"端到端架构 + 即时外部工具"的可扩展性与灵活性,但在特定工具上仍受局限。
端到端 VLA 模型方面,大规模多模态模型的成功 推动了用端到端方法生成通用机器人策略 :基础模型 π 在时刻 t 根据观测 o_t 直接预测动作块 A_t。该观测 o_t 包含语言指令 l、视觉数据 I_t 与本体感知状态 q_t,动作 a_t 为连续控制信号(d 自由度时 a_t∈R^d)。该端到端模型可直接把人类指令映射到机器人动作并泛化到多场景 。为提升规划与动作精度,后续方法让模型 π 预测中间可供性 o*_t(如物体边界框 或操作关键点 )来引导后续动作生成,形式化为 π = π_2 ∘ π_1, π_1: o_t ⇝ o*_t, π_2: (o_t, o*_t) ⇝ A_t (3)。但该方法把"语言→动作"映射简化成手工函数,在需要复杂语言理解与灵巧动作生成的任务上力不从心 。
本文核心思想很简单:我们把模型的动作空间扩充为 A* = A × R × T,其中 R 是语言推理空间,T 是工具使用动作空间。动作 a*{t,t} 旨在通过推理观测来组合信息,而 a{t,t}∈T 用于激活外部工具以增强观测;于是任务的解被表示为一条轨迹 (a*_1, …, a*_T)。每个工具函数 f_i∈F 的状态用离散动作 a_t∈{0,1}^n 表示(第 i 个元素指示第 i 个工具 f_i 的开/关),从而把工具使用建模成一种离散决策,并映射到词表末尾的 N 个 token(沿用 RT-2 与 OpenVLA 的做法),尽量不影响原词表。
为了展示该框架"高泛化、低数据依赖"的优势,我们先用现有 VLA 数据构建了一个 3 万条工具调用轨迹与动作示范的数据集,规模远小于基线方法。受 T3-Agent 启发,我们提出一条扩展现有 VLA 数据集的新流程:通过"任务设计→推理生成→工具轨迹合成"三步,高效生成大量工具使用数据——先系统性地"劣化"现有 VLA 数据(在任务指令中引入复杂性,制造必须用工具才能解决的子任务),再让基础 VLA 模型生成调用所需工具的推理过程,最后把这些推理合成为完整工具使用轨迹。该方法无需昂贵的人工新动作数据采集。为防止微调新工具数据时的灾难性遗忘,我们定义了两段式 LoRA 微调:工具使用训练阶段冻结原始 VLA 权重,只微调专用于工具推理的 LoRA 模块;一旦 VLA 已学会使用工具,我们在动作生成时屏蔽(mask)LoRA 层输出,让模型回到原始动作输出能力——这种策略性解耦把工具推理与核心 VLA 模型分开,避免数据冲突并保留高质量动作生成。
综上所述,我们的关键贡献如下: • 我们提出一种把多模态工具集成进现有 VLA 数据集的数据生成方法,使长任务链中的复杂工具使用成为可能。 • 我们提出 ART(Agentic Robot with Tool-use),一种面向 VLA 模型的微调"工具注入"框架,在保留预训练 VLA 动作生成能力的同时,赋予其新的工具推理能力。 • 通过在 LIBERO 仿真与真实世界环境中的实验,我们证明该方法增强了模型处理新场景、新物体与新动作指令的鲁棒性。
主要贡献
• 我们提出了一种将多模态工具集成到现有 VLA 数据集中的数据生成方法,使长任务链中的复杂工具使用成为可能。
• 我们提出 ART(Agentic Robot with Tool-use),一种面向 VLA 模型的微调"工具注入"框架,在保留预训练 VLA 动作生成能力的同时,赋予其新的工具推理能力。
• 通过在 LIBERO 仿真与真实世界环境中的实验,我们证明该方法增强了模型处理新场景、新物体与新动作指令的鲁棒性。
方法
一句话核心思路: 把"工具调用"作为一种离散动作注入任意端到端 VLA 模型的词表,再用 3 万条工具调用轨迹做两段式 LoRA 微调,让模型学会"何时调哪个工具、调完再怎么动",从而把现成 VLA 即插即用地升级为会调外部工具的智能体,全程无需重训整个模型。
ART 把任意端到端 VLA 模型升级为能调用外部工具的智能体。其形式化目标是:在时刻 t,模型 π 接收清晰、高质量的观测 o_t,预测动作 a_t∈A;但在真实场景中观测常含噪声与各类腐化,阻碍模型学习"观测→动作"的映射。ART 把动作空间扩充为 A* = A × R × T(R 为语言推理空间,T 为工具使用空间),把工具激活建模为离散决策(用词表末尾 token 表示各工具的开/关),整体优化目标为最大化轨迹 a*{1:T} 在增强观测 o~{1:T} 下的概率 (4)。
下面按"动作空间如何定义 → 工具如何接入 → 如何训练"三步,拆解 ART 的工具调用机制:
(a) 工具调用如何形式化(动作空间扩充)。 ART 把动作空间从连续的 A 扩展为 A* = A × R × T:A 是原始连续动作,R 是语言推理空间(让模型先"想清楚"再动),T 是工具使用空间。每个工具 f_i 的开关用离散向量 {0,1}^n 表示——第 i 位为 1 即激活第 i 个工具。该离散决策被映射到词表末尾的 N 个新 token(沿用 RT-2 / OpenVLA 的做法),尽量不动原词表,因此工具调用对底座模型而言只是"多了一类可输出的 token",侵入性极低。
(b) 工具如何接入与执行(LoRA 注入 + 增强观测)。 架构上,ART 在原始 VLA 上接入一个微调过的 LoRA 模块:推理阶段,模型先基于原始观测 o_t 生成推理 token 与工具使用动作 (a^r_t, a^t_t),由 LoRA 激活外部工具(视觉增强、可供性增强、具身增强);被增强后的观测 o~_t 再送回模型,生成最终具身动作 a_t。考虑到现代 VLA 普遍采用 action chunking,工具推理每隔 H 步触发一次,被选中的工具在接下来 H 步观测上持续生效,兼顾效率与效果。
(c) 两段式 LoRA 训练(解耦工具推理与动作生成)。 训练包含两条互不干扰的损失:工具推理损失 L_tool 用 next-token prediction 监督 (a^r_t, a^t_t);动作损失 L_action 则在增强观测上以自回归方式监督具身动作 a_t。训练时冻结原始 VLA 主干、只训 LoRA;推理生成动作时屏蔽 LoRA 输出,模型即可随时退回原始动作能力。数据上,通过"劣化现有 VLA 数据 → GPT 把简单任务改写成需要推理/工具的复杂任务 → 合成工具轨迹"的流程,低成本把工具使用数据扩展到 3 万条。

▲ ART 架构总览。借助微调后的 LoRA 模块,ART 先对原始观测做推理,预测用于激活外部工具的"工具使用动作",从而改善输入数据。具体而言,外部工具提供视觉增强、可供性增强与具身增强。在获得增强后的观测后,模型生成最终的具身动作。

▲ ART 数据采集流程总览。核心思想是充分利用已有的机器人数据集。(1) 任务生成:对于视觉与具身模态,随机引入一些扰动;对于语言模态,用 GPT 将原始数据集中的简单任务改写为需要推理 / 工具使用(可供性信息)的复杂任务。(2) 工具链生成:为消除扰动、完成可供性推理所需的工具被记录成一条推理链。(3) 轨迹生成:用 GPT 把这些工具与推理串联,生成完整的长程工具调用轨迹。
笔者理解。 ART 的巧妙之处在于"增量式"而非"推倒重来"。它不重训整个 VLA,而是把工具调用训在独立的 LoRA 上,并将该 LoRA 从动作生成路径中解耦——工具数据只教"何时调工具",原始动作能力始终被冻结保留,因此既不会因新数据而灾难性遗忘,也无需为每个新场景从头收集海量动作示范。对工程落地而言,这意味着已有 VLA 底座可低成本"插上"检测、深度、暗光增强等现成模块:新能力即插即用、可独立迭代,部署与扩展都更轻量,这正是它相比纯端到端重训最实在的优势。
实验结果
ART 的核心优势是能即时(on-the-fly)集成外部工具,无需重训整个模型即可适配各类复杂任务。在 LIBERO 仿真与真实 Astribot S1 机器人任务上,ART-FAST 的平均成功率分别达到 75% 与 **62%**;而 OpenVLA、π0 等 SOTA VLA 模型在视觉/语义/具身扰动下平均成功率显著低于 **30%**——这正说明工具推理可弥补传统 VLA 在噪声/不完整观测下的短板。综合来看,ART 相对主流基线成功率提升约 **20%**。
主结果:LIBERO 仿真 + 真实机器人双榜领先(Table 1)。 如表 1 所示,在 LIBERO 的 Vision / Affordance / Embodiment 三类扰动任务上,ART-FAST 平均成功率约 **75%**,远超 OpenVLA、π-FAST 等基线(均低于 30%);在真实 Astribot S1 人形机器人上,ART-FAST 平均 **62%**,同样遥遥领先。更关键的是,这种工具推理能力在 AT 数据集(含 LIBERO、Bridge v2、DROID)上微调后,可直接泛化到全新的真实机器人场景而无需任务专属重训——这是纯端到端模型难以做到,也是 +20% 优势的真正来源。
为什么有效:工具使用让模型在"脏观测"下仍鲁棒(Table 2)。 与"仅推理"模型 ECoT 的对比更具说服力:无视觉腐化时,ART 与 ECoT 在可供性任务上成功率接近(62% vs 58%);一旦加入视觉腐化,ECoT 骤降到 **12%**,而 ART 借助外部视觉增强工具仍保持 **72%**。这说明 ART 的优势不在干净数据,而在复杂 / 噪声环境下——工具先把"看不清"的观测补强再决策,避免了 ECoT 因分布外输入而失效,也印证了"即插即用调工具"的工程价值。

▲ 即时工具使用带来的性能提升。我们在不同泛化任务上对比了 ART 与多个主流 VLA 模型的成功率。LIBERO 实验表明,工具使用显著提升了模型在复杂场景下的能力;Astribot S1 实验表明,在 AT 上微调出的工具推理能力可泛化到全新的机器人场景。

▲ 与"仅推理"模型的性能对比。我们在 AT 的可供性部分测试了 ECoT 与 ART 的成功率,分别在有 / 无视觉腐化两种条件下进行。
总结
与端到端 VLA 模型的对比:本节把工具使用方法与传统端到端 VLA 模型比较,具体考虑两类基线——仅动作模型与仅推理模型。本文提出 ART(Agentic Robot with Tool-use),一个桥接模块化与端到端 VLA 模型的微调框架。它使 VLA 模型能够利用外部工具处理新任务,且不牺牲其精度或连续动作能力。我们的方法把多模态工具使用集成进现有 VLA 数据集,减少对全新数据采集的需求,并采用两段式 LoRA 微调流程把工具推理与核心 VLA 任务解耦,从而缓解灾难性遗忘。在 LIBERO 仿真与真实世界环境中的实验表明,ART 增强了模型的鲁棒性与泛化能力,能有效地处理新物体、新场景与新动作指令。ART 降低了数据依赖,为动态环境中更具适应性的机器人智能体铺平了道路。
本文仅做学术分享,如有侵权,请联系删文。
。


扫码添加微信,备注:姓名+方向+单位,邀请入群。