点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
来源:3D视觉工坊
3D视觉硬件包括结构光3D相机(支持室内外,焊接,机械臂抓取等),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
训练一个机器人操作策略,通常意味着采集演示、训练模型、再部署。RoboScript走了另一条路线:冻结基础模型,只给一段演示,让它在仿真器里学习,把世界的反馈写进一份可读的任务记忆,再通过复盘持续自我进化。在 RoboTwin 2.0 全部 50 项双臂任务上,它只在干净(clean)场景中学习,直接到从未见过的随机化(randomized)场景中评测:两种场景平均成功率达到 83.4%,随机化场景仍有 83.2%,几乎不掉点。相比之下,主流的视觉-语言-动作(VLA)模型和世界动作模型(WAM)即使用官方全量的干净专家演示训练,到了随机化场景也会大幅掉点,例如 π₀.₅ 从 70.7% 降到 46.0%。仿真中学到的任务记忆无需重新演示和学习,就能迁移到真机,还可以跨机器人本体复用。

论文:World In-Context Learning for Agentic Robot Manipulation
项目主页:https://ArcheOne-AI.github.io/RoboScript
代码:https://github.com/ArcheOne-AI/RoboScript
机器人能不能像在权重里学会一项操作任务那样,在上下文里学会它?
这正是 RoboScript 想回答的问题。
主流的视觉-语言-动作模型(VLA)和世界动作模型(WAM)把操作技能训练进权重,学到的东西也就和训练分布绑在一起。FastWAM 在 RoboTwin 2.0 干净场景上的成功率为 77.8%,换到随机化场景后只剩 1.9%。上下文学习(ICL)不改权重,却一直没能追上训练出来的策略:演示录自另一个场景,没法告诉机器人眼前这张桌子上会发生什么。
Coding Agent 给出了缺失的那一环。它们在终端里运行代码、读取输出、再修改,以此学会陌生的代码仓库。RoboScript 把这套机制搬到机器人身上,用世界取代终端。团队的关键观察是:Agent 在上下文里学到的是语义,即物体的角色、任务的步骤、上次哪里出了错,而不是画面的外观,因此在一个世界里积累的经验可以带到另一个世界。
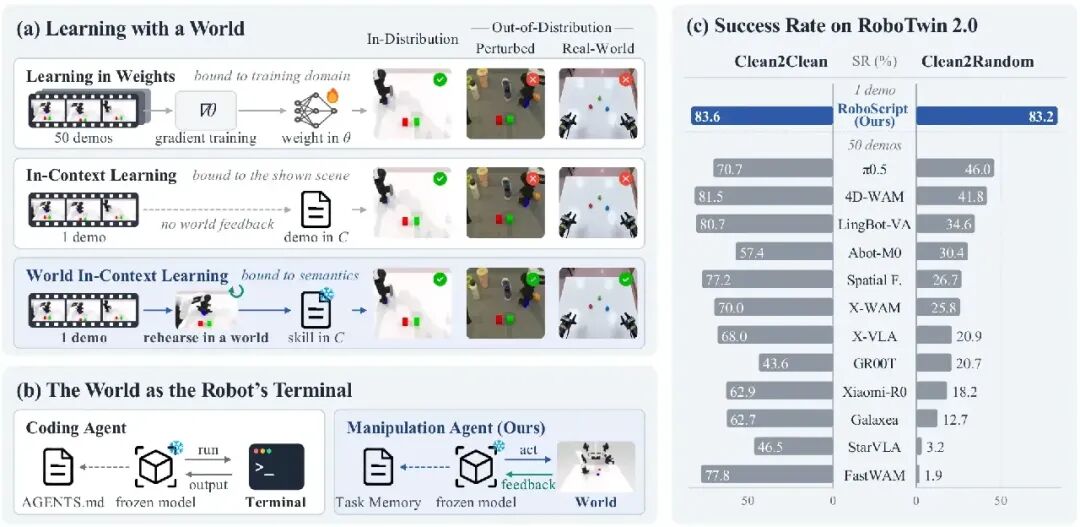 图 1:(a) 三种学习范式;(b) 把 Coding Agent 的终端换成世界;(c) RoboTwin 2.0 上的成功率。
一条专家演示,超过全量干净数据训练的模型
实验覆盖 RoboTwin 2.0 的全部 50 项双臂任务,分为干净设置和随机化设置(纹理、光照、桌面高度和干扰物随机)。RoboScript 每个任务只用一段干净演示,也只在干净场景里排练,冻结后的记忆在两种设置下按官方协议评测。对比的 VLA 和 WAM 则使用官方全量的干净专家演示训练。
 表 1:RoboTwin 2.0 全部 50 项任务的平均成功率(%)。保持率 = 随机化成功率 / 干净成功率;† 仅报告随机化设置。
一段演示加排练就够了:RoboScript(GPT-6.1-Sol)平均达到 83.4%,最强的训练策略 4D-WAM 为 61.7%。两者在干净场景相当(83.6% 对 81.5%),差距来自随机化:4D-WAM 掉到 41.8%,RoboScript 仍有 83.2%。 跨分布几乎不掉点:三个基础模型在随机化下保留了干净成功率的 95.2% 到 100.8%,训练策略最多只有 65.1%。RoboScript 从未见过随机化场景,仍比用 RoboTwin 数据微调过的 HarnessVLA(58.4%)高出 24.8 个点。 不依赖最强的模型:代码、提示词和协议都不变,DeepSeek-V4.1-Flash 和 GPT-5.6-Luna 也分别达到 78.1% 和 77.9%,同样高于所有训练策略。
世界上下文学习:把世界反馈写进上下文
团队把这一范式称为世界上下文学习(World In-Context Learning,WICL),它和 ICL 的关系,类似强化学习和模仿学习的关系。冻结的模型先读一段演示,写出初始上下文;再在世界里排练,由同一个模型把每次的轨迹和反馈改写进上下文;收敛后冻结,到从未排练过的实例上执行,不再接收任何反馈(图 2a)。排练和评测实例互不重叠,成绩衡量的是泛化,而不是记忆。
这样学到的知识能跨世界迁移,是因为上下文只引用任务语义:有哪些物体、各自扮演什么角色、相互的几何关系。只要另一个世界在语义上一致,即使外观、光照或物理参数不同,知识依然适用;权重则会吸收训练世界里的一切规律(图 2c)。上下文又是可读的文本,Agent 可以复盘自己的评测记录、写下指导,在权重不变的情况下递归自我改进(图 2b)。
 图 2:(a) WICL 流程;(b) 在互不重叠的评测块上自我改进;(c) 上下文知识只依赖共享语义,可以跨世界迁移。
RoboScript:四个阶段,全程不改权重
RoboScript 把 WICL 落到机器人操作上,生命周期分为四个阶段(图 3):
构建技能:抓取、放置、双臂协同等共享入口与具体环境无关;演示里遇到现有入口解释不了的动作,Agent 交给 Coding Agent 编写新技能。每个动作都返回一张“回执”,写明实际到达的位姿、夹爪开度和是否握住物体,让 Agent 分清“命令执行了”和“效果达到了”。 从一段演示学习:先模仿(S1),在演示场景上练到稳定成功;再排练(S2),在新场景上只算第一次尝试,失败后修改记忆的缓存副本,只有修改让这个场景成功才会合并。 部署:动手前把演示的语义蓝图映射到当前场景,确定物体角色和该用哪只手臂;动作失败不重置,退到安全位姿重新观察后继续;只有确认场景与演示终态一致,才宣布完成。 复盘:评测完一批场景,复盘 Agent 只看部署时可得的记录和成败,自己诊断失败原因,为下一批写下指导。
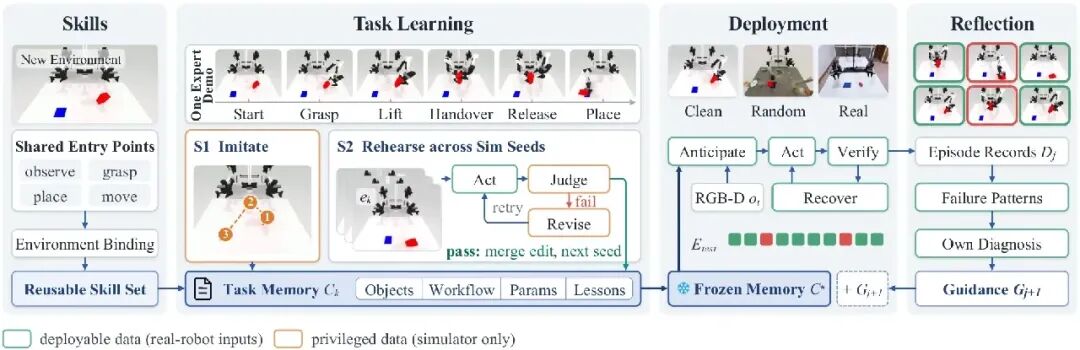 图 3:RoboScript 的四个阶段。绿框为真机同样可得的数据,橙框为仅仿真器可得的特权数据。
学到的东西都写在 Task Memory 里。它是一份结构化 Markdown,记录物体角色、分阶段的工作流、相对的抓取与放置规范、参数和教训。规范以物体部件为参照,例如“从左侧接近把手,在其中点抓取”;记忆检查器(Linter)会拒绝任何坐标和仿真器专有信息。
Infrastructure:积木式组装,数据严格隔离
RoboScript 运行在一套模块化基础设施上(图 4):方法、基准、机器人本体和基础模型都是独立服务,像积木一样可以单独替换。所有模型调用经过同一个网关,换基础模型只需改配置;仿真器、世界模型和真机都能作为“世界”接入。
在仿真里学,只用真机拿得到的输入。 执行动作的 Agent 只能看到 RGB-D 图像、本体状态等真机同样可得的数据;物体真值位姿、成功判定等特权数据只有控制平面能访问,仅用于监督学习,评测时一律拒绝调用。因此,仿真中学到的记忆可以直接部署到真机上。
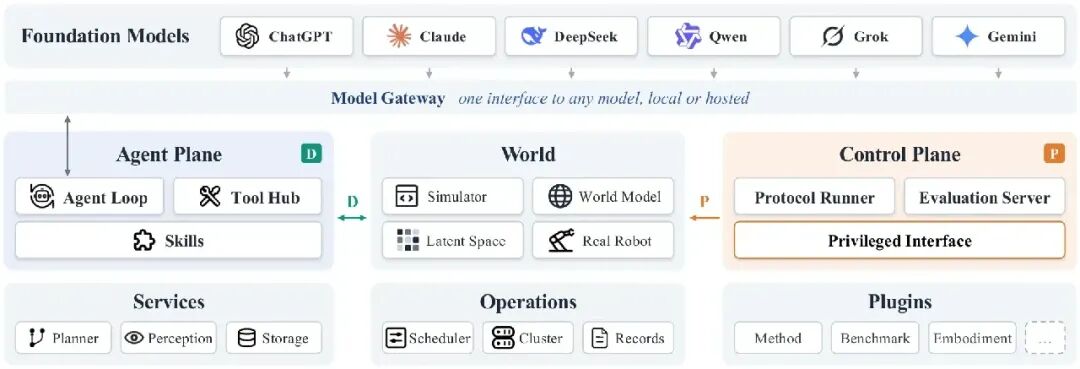 图 4:RoboScript 的基础设施。Agent 平面只经由可部署接口(D)与世界交互,只有控制平面能访问特权数据(P)。
随机化之后,为什么几乎不掉点
逐任务看,π₀.₅ 的大多数任务在随机化后系统性下滑,RoboScript 的三个模型基本落在 ±10 个点以内,没有任务掉点超过 20 个点(图 5a)。GPT-6.1-Sol 的 166 条失败中,知识类失败在干净和随机化设置下分别为 37 条和 38 条,几乎不变;感知类略降(22 → 17),执行类略升(23 → 29),与随机化桌面高度让动作更难做相吻合(图 5b)。随机化带来的失败是物理层面的,而不是“不知道该怎么做”。
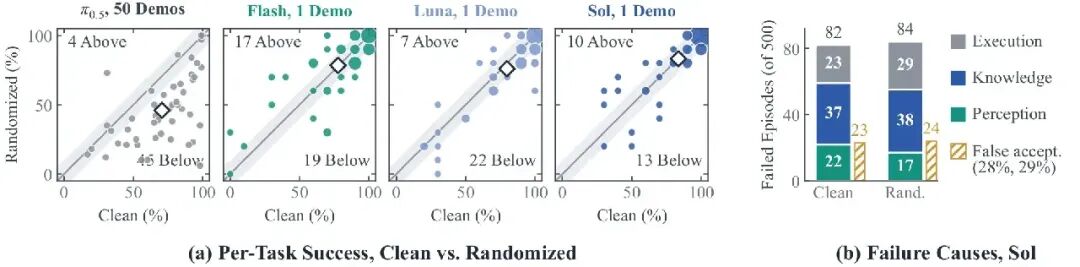 图 5:(a) 逐任务的干净与随机化成功率;(b) 失败的根因分布。
消融:演示定锚,恢复保底
团队在覆盖五类任务的 10 个任务上做了消融,每个变体都与完整方法在相同种子上配对比较(表 2)。
 表 2:消融实验。第一组部署冻结的记忆,第二组不与世界交互、直接构建记忆,第三组从头重新学习。
演示和世界缺一不可:只凭演示写出记忆、不在世界中学习,成绩从 78.5% 降到 69.0%,与只给指令(68.0%)几乎没有差别;反过来,不给演示、只靠指令在世界中学习,成绩从 86.0% 跌到 56.5%,是全表最大的落差。 排练补上演示覆盖不到的细节:在 11 个更难学的任务上,去掉排练后成绩从 54.5% 降到 46.1%,随机化场景下差距扩大到 13.3 个点。 失败恢复最关键:第一次失败就结束 episode,成绩从 78.5% 降到 69.0%,是部署组中最大的落差;去掉选臂检查和完成检查,分别降到 75.0% 和 77.0%(图 6)。 特权监督不是性能的来源:去掉学习阶段的全部特权输入,成绩为 86.5%,与完整方法的 86.0% 持平。
 图 6:冻结 Task Memory 的部署过程。(a) 把演示换到另一只手臂执行;(b) 对照演示检查,补上被跳过的步骤;(c) 物体滑落后重新抓取。蓝框为演示,红框为出错,绿框为成功。
图 7:RoboTwin 2.0 上 20 个任务的执行片段,包含干净和随机化场景,随机化场景从未排练过。
递归自我改进:每一轮复盘都带来净提升
复盘 Agent 会把评测中的失败总结成可读的指导,留给下一轮使用,全程不改任何权重。团队连续做了三轮,每轮换一批新场景,并在相同场景上对比有无指导:在较弱的任务上,每一轮指导挽回的失败都多于新引入的失败,提升幅度逐轮收窄,但始终为正。以 handover_block 为例,两条指导先纠正了 Agent 对指令的误读,再提醒它对照垫子边缘检查放置位置,同一批场景就从不到一半成功变为全部成功。
 图 8:三轮递归自我改进。
仿真里学会,真机上部署,还能跨机器人本体
团队把在仿真 ALOHA 上学到的 Task Memory 直接迁移到真实的双臂 PiPER 上。两者运动学结构不同,但记忆只描述任务语义,简单适配后即可使用,无需重新演示和学习。同一份记忆既跨过了仿真到真机的鸿沟,也跨越了不同的机器人本体,在四个真机任务上都能成功执行(图 9)。
图 9:真机 PiPER 上四个任务的表现。记忆在仿真 ALOHA 上学得,简单适配后直接使用,无需重新学习。
这项工作说明了什么?
RoboScript 的结果支持一个判断:操作技能不一定要存在权重里。只要能在仿真器这样的世界里反复尝试、获得反馈,冻结的基础模型就能从一段演示出发,通过学习把技能写进可读的上下文。这样学到的知识是语义的,所以跨分布稳定;它与模型解耦,所以换模型不用改代码;它可读可改,所以权重不变也能通过复盘持续自我进化;它不绑定特定的机器人,所以能从仿真迁移到真机,还能跨本体复用。
它也有清晰的边界:
依赖闭源 API 模型,服务稳定性和推理速度都受制于外部接口,每一步动作都要等待模型响应; 需要精细接触或双臂紧密配合的复杂操作,目前仍是难点。
尽管如此,RoboScript 的模块化设计让它很容易扩展到新的任务、本体和基础模型,效果也会随基础模型一同进步。让机器人在与世界的交互中持续学习,世界上下文学习或许正指向具身智能的未来。
正如论文结尾所说:有了世界在回路中,机器人在上下文中学会一项操作任务,可以和在权重中学会它一样好。
本文仅做学术分享,如有侵权,请联系删文。
。


扫码添加微信,备注:姓名+方向+单位,邀请入群。