今年 6 月,AMD 接手了名为 MEXT 的预测式内存引擎。按这项技术当时的说法,物理内存条最少可以只装满配的 25%,性能仍能达到一套装满 DRAM 的系统的 99% 以上。冷页(长时间未被访问的内存页)被卸到闪存上,人工智能模型则在页面真正被用到之前先把它送回来。AMD 表示,明年准备把这项技术铺到内部相当大比例的 IT 基础设施上。
这个说法听上去好得让人难以尽信。AMD 与 MEXT 创始人加里·斯默登(Gary Smerdon)称,看应用和性能目标,服务器里实际要装的 DRAM 可以削减 20% 到 75%。少掉的那一部分,操作系统仍然把它当成已经安装的 DRAM。真正承接冷页的不是内存条,而是相对便宜的闪存,要用的时候再由模型调回来。在 AMD 内部的一些负载上,例如新思科技 PrimeTime(Synopsys PrimeTime),公司称 DRAM 只有一半时,性能仍能达到满配服务器的 95%。
AMD 已经在内部 145 台服务器上部署 MEXT,并称 2027 年将扩到 2,000 台。公司同时宣布与慧与(HPE)合作,把 MEXT 提供给客户。眼下是第一阶段。部分 EPYC Venice 服务器带有 “MEXT Ready” 标识,并留出专用的 NVMe 硬盘或盘位,用来承接卸出的页面。第二阶段才会向这些服务器发放 MEXT 许可证,并带上 RAM View 应用。AMD 没有说第二阶段何时开始。
人工智能把 DRAM 价格推上去之后,受影响的不只是游戏 PC。企业即使不跑人工智能负载,也同样在承受涨价。假如 MEXT 真能做到 AMD 所说的程度,以现在的市场,影响会很大。因此有必要先看清它是什么,以及 AMD 声称它能做到哪一步。
概念本身吸引人,AMD 的推进却明显偏保守。这么高的性能宣称,需要相应扎实的证据。目前适用的负载仍然有限。公司称正在把 MEXT 扩到更多负载上,早期结果看起来不错。
冷页进闪存,模型提前把页调回来
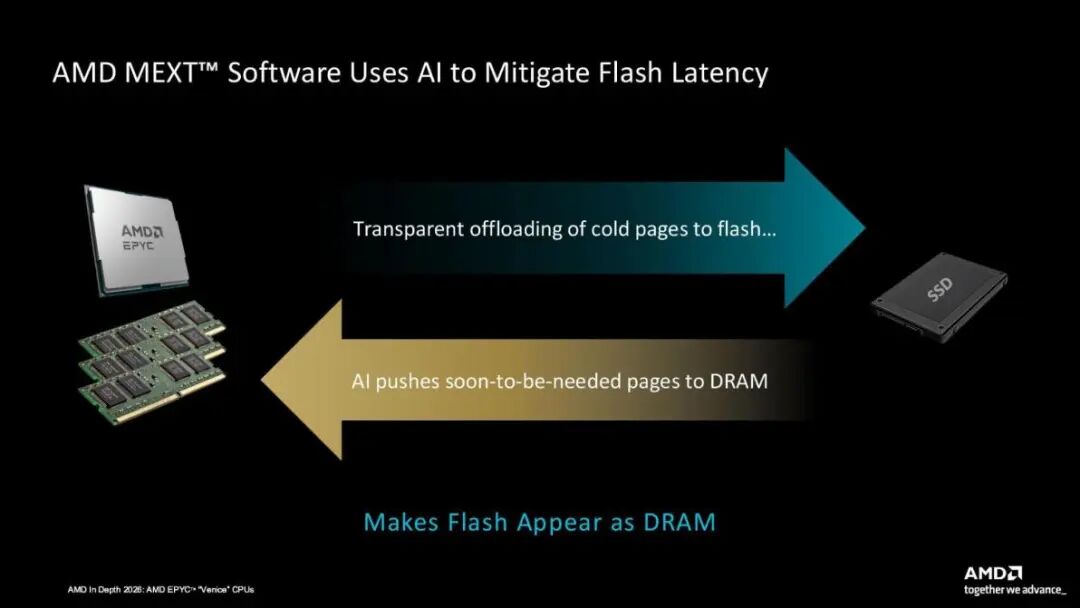
图:AMD MEXT 软件用人工智能缓解闪存延迟。冷页透明地卸到闪存,模型再把即将用到的页推回 DRAM,使闪存在系统里表现为 DRAM。图源:AMD
基本做法在概念上并不复杂。冷页进入闪存,人工智能在需要时把页面调回,看起来就像内存从一开始就没有少过。难点也很明显。闪存比 DRAM 慢几个数量级,等某一页要用了再从闪存往回搬,并不现实。MEXT 的办法,是用模型预测接下来会用到哪些页。只要预测至少提前一个 SSD 的传输延迟,把页准备好,效果就接近物理 DRAM 一直装着。
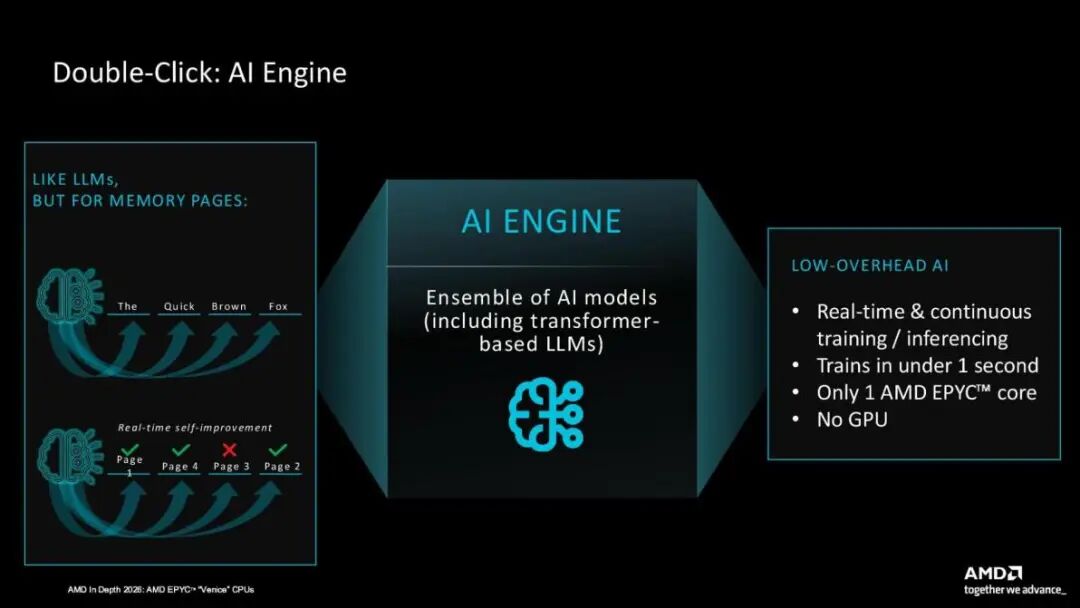
图:MEXT 的人工智能引擎。一组模型里包括基于 Transformer 的大语言模型;训练不到 1 秒,只占用 1 颗 AMD EPYC 核心,不使用 GPU,并在运行中持续训练和推理。图源:AMD
MEXT 用的是基于 Transformer 的大语言模型,工作方式和这类模型一样:给定一组 token,预测下一个最可能出现的 token。放到内存上,它预测的不是下一个词,而是下一页。
把内存页卸到闪存并不是新做法。斯默登认为,这项技术真正不同的地方在于人工智能。MEXT 以 Linux 内核模块的形式部署,可以配合各种 Linux 发行版。它使用“一组人工智能模型”,起主要作用的是基于 Transformer 的大语言模型。模型并不事先训练好再交出去。
AMD 称,MEXT 第一次部署时,不到一秒就能完成训练,只占用一颗 EPYC 核心,不使用 GPU,并且在负载往下跑的过程中持续训练。负载彼此差别很大,这种做法因此说得通:它学的是这个应用程序自己的访问模式,再靠这个模式去驱动预测。
MEXT 并不完美,也不是每一种情况都得完美。页面存放的先后顺序就是一个例子。文本里,模型必须按正确的顺序给出正确的词;MEXT 不要求顺序正确,只要某一页被用到时已经在 DRAM 里就行。
为了看清不同负载该怎么用 MEXT,AMD 配套做了内存占用工具 RAM View,用来显示哪些页是热的、哪些已经变冷。

图:RAM View。一套 1.5 TB 的系统看起来规模合适,实际用得上的更接近 768 GB,其余为冷页,并按距上次访问的时间分档。图源:AMD
AMD 给的是一个概括例子,没有说明测的是哪一种负载。这一点很要紧。服务器上跑的应用不同,内存占用会差很多。图上这套系统有 1.5 TB 内存,整个负载期间看起来接近用满,也没有明显的闲置或过度配置;真正用得上的更接近 768 GB,其余当时是冷的。任意一个时刻,大约一半页面已经有五分钟或者更久没有被访问。图上还按距离上次访问的时间分成多档,从不到 15 秒一直到超过 5 分钟。
AMD 起初把 MEXT 用在内部关键的电子设计自动化负载上,PrimeTime 就是其中一项,同时也在针对智能体人工智能、数据库,以及媒体和娱乐负载做优化。

图:AMD 称为“内存墙”的示意。不使用 MEXT 时,DRAM 削减到一定程度后性能陡降;使用之后,预期性能下降更缓。图上注明仅为示意。图源:AMD
访问模式不同只是一方面。内存不够的时候,各类应用的性能变化也不一样。AMD 把这道坎叫作“内存墙”,并说 MEXT 是在把墙往外推。不同应用上,墙的位置并不相同。这张图自己标明只是示意,实际性能以及能够削减的 DRAM 比例,会随负载和系统配置变化。
公司比较有把握的是,许多负载大约可以削减 20% 到 25% 的容量。削减比例再提高,适用的应用就更专门,和满配相比的性能差距也会拉大。图上在削减大约 25% 的位置,把“许多负载”标在接近满配性能的地方;削到 50% 和 75% 时,智能体人工智能、数据库与分析、电子设计自动化和芯片设计这几类的预期性能逐级走低。
内部成绩怎么报
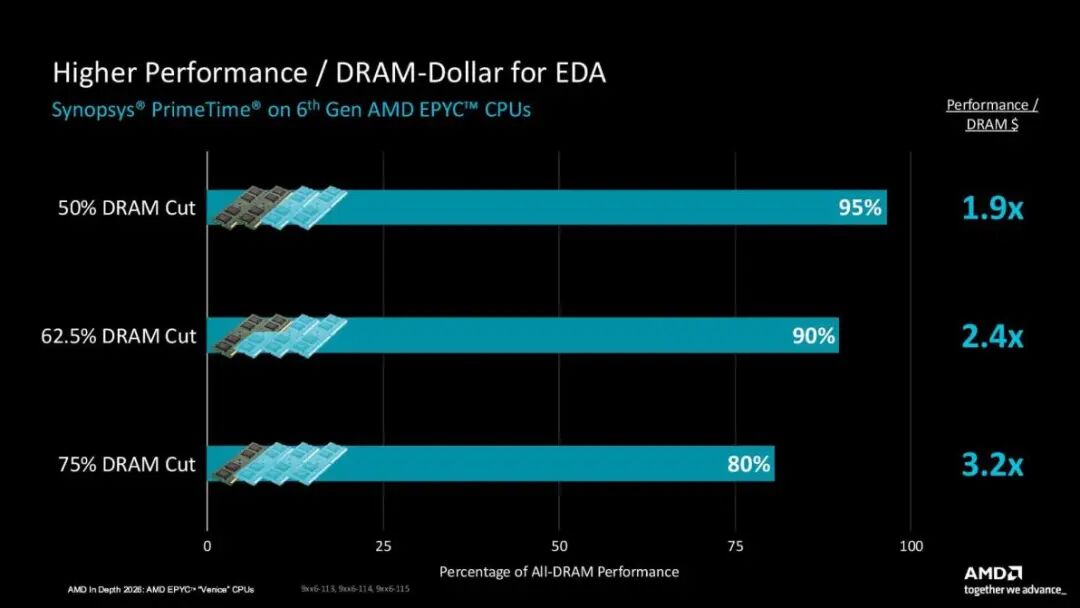
图:PrimeTime 在第六代 EPYC 上的第一方结果。DRAM 削减 50%、62.5%、75%,性能分别为满配的 95%、90%、80%。图源:AMD
AMD 公布了一批内部结果。数字很亮眼,第一方基准测试照例要留有余地。PrimeTime 是公司到目前为止在 MEXT 上花力气最多的一项。公司称,DRAM 削减 50% 时,仍能保留满配服务器 95% 的性能;削减 75%、容量只剩 25% 时,应用性能仍能维持 80%。幻灯片把三档写成 DRAM 削减 50%、62.5% 和 75%,对应性能分别是满配的 95%、90% 和 80%,并给出相对于 DRAM 支出的性能倍数,为 1.9 倍、2.4 倍和 3.2 倍。幻灯片写明,这组 PrimeTime 跑在第六代 AMD EPYC 上。
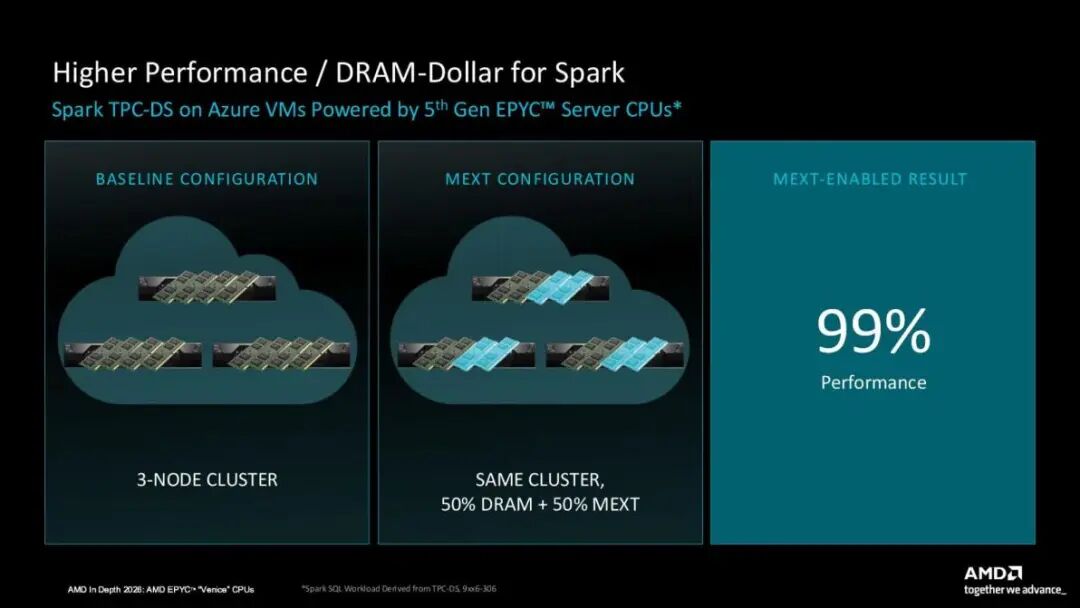
图:Azure 上第五代 EPYC 的三节点集群。同一集群改为 50% DRAM 加 50% MEXT 后,Spark SQL 性能为满配的 99%。图源:AMD
大型设计会让 PrimeTime 占用大量内存。也有一些应用,性能几乎看不出差别。AMD 称,在 Azure 上用第五代 EPYC 组成的三节点集群里,跑 TPC-DS 基准中的 Spark SQL,DRAM 容量为 50% 时,MEXT 可以达到完整集群性能的 99%。SQL 数据库会尽量把数据缓存在内存里,以免输入输出成为瓶颈,这正好给想把冷页腾出来的技术留出空间。幻灯片把同一集群的配置写成 50% DRAM 加上 50% MEXT。

图:第六代 EPYC 上的智能体人工智能测试。五智能体并发在 50% 与 25% 内存下分别为满配性能的 99% 和 85%;内存需求很高的智能体为 90% 和 88%。图源:AMD
眼下更贴切的一类负载是智能体人工智能。AMD 称,MEXT 在这里也有相近的表现。五个智能体并发的几何平均,在 50% 内存容量下达到满配服务器性能的 99%,在 25% 容量下为 85%。对一个内存需求很高的智能体,50% 和 25% 容量对应的性能分别是 90% 和 88%。幻灯片同时给出相对于 DRAM 支出的性能倍数,上述四档为 1.9 倍、1.7 倍、3.4 倍和 3.5 倍,并写明测试跑在第六代 EPYC 上。
这张幻灯片带有脚注标记。AMD 还没有把脚注交给 Tom's Hardware,因此看不到测试具体怎么跑。可以认为,公司至少会以尽可能有利的方式来呈现这些数字。不知道测试条件,就做不成完整的核对。
推进仍然保守
更显眼的是 AMD 把推出节奏放得很慢。MEXT 目前只提供给 EPYC。公司没有关上以后支持其他产品的门,消费级设备例如 Strix Halo 也留在可能的范围里,但那还很远。卖法会是一张许可证,并与 RAM View 软件捆在一起,时间表还没有。慧与那边已经在推带 “MEXT Ready” 标识的服务器,MEXT 本身何时能在 AMD 以外部署,仍然没有说法。
以这种节奏来看,MEXT 可能还有尚未暴露的限制。至少在基准所展示的 50% 和 25% DRAM 容量上,很难想象它能直接套到每一台服务器。
即便如此,在眼下供应受限的环境里,一台服务器能削掉 25% 的 DRAM,本身就是很大一笔成本节省。如果有些负载可以只留一半容量,节省还会更大。MEXT 广泛可用之后到底怎么样,还得等它真正铺开再看。若 AMD 的说法站得住,它有可能成为内存始终难以备齐的数据中心里一项关键技术。
今日推荐: