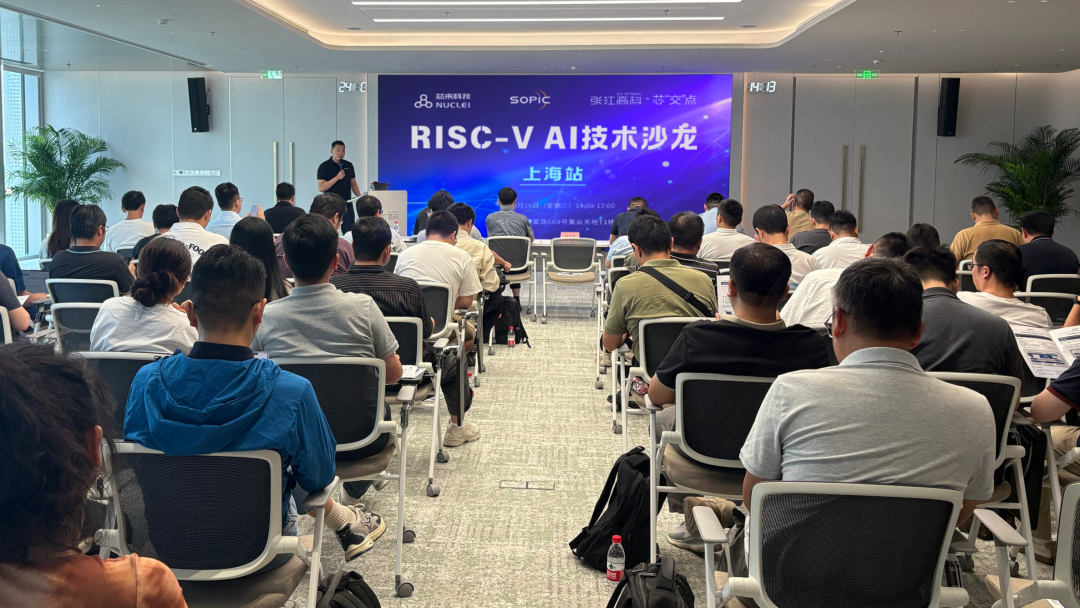
9月16日,由芯来科技、上海开放处理器产业创新中心、上海张江高科技园区开发股份有限公司联合主办的“RISC-V AI技术沙龙-上海站”活动成功举办。
本次RISC-V AI技术沙龙汇聚了来自产业链上下游相关企业及众多RISC-V技术领域爱好者,聚焦NPU异构加速、3D堆叠存算及超节点Scale-up等议题,展开从单核到集群、从指令到系统的全栈式技术对话,为AI芯片的架构创新提供可落地的解题思路。

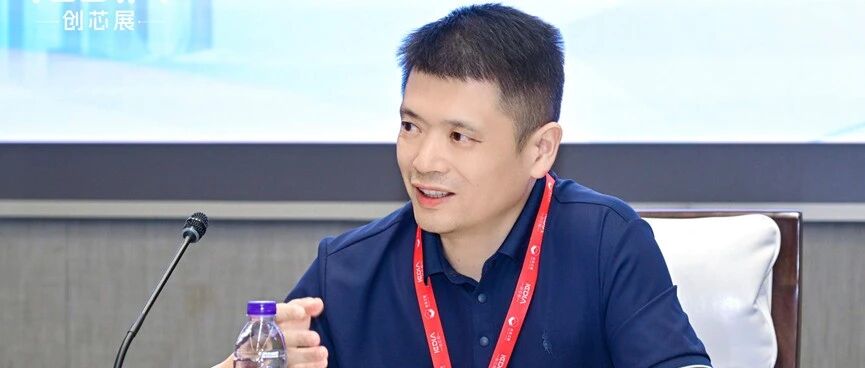
会议开始,上海开放处理器产业创新中心副秘书长孙翊飞为本次AI技术沙龙作开场致辞。致辞中指出,RISC-V正迎来爆发式增长,全球处理器市场格局正加速向“三足鼎立”的新纪元迈进。凭借开放、灵活、可定制优势,RISC-V成为云端算力与端侧智能的首选架构,国内外行业龙头纷纷布局RISC-V,也印证了其巨大商业价值。上海开放处理器产业创新中心将持续做好企业与政府的沟通桥梁,推动RISC-V产业政策落地,积极促成行业共识的形成与技术的规范化发展。致辞最后感谢大家到场参与本场沙龙,并预告“2026 RISC-V产业生态大会”将于今年12月举办,诚邀同仁关注参与,共推产业繁荣。


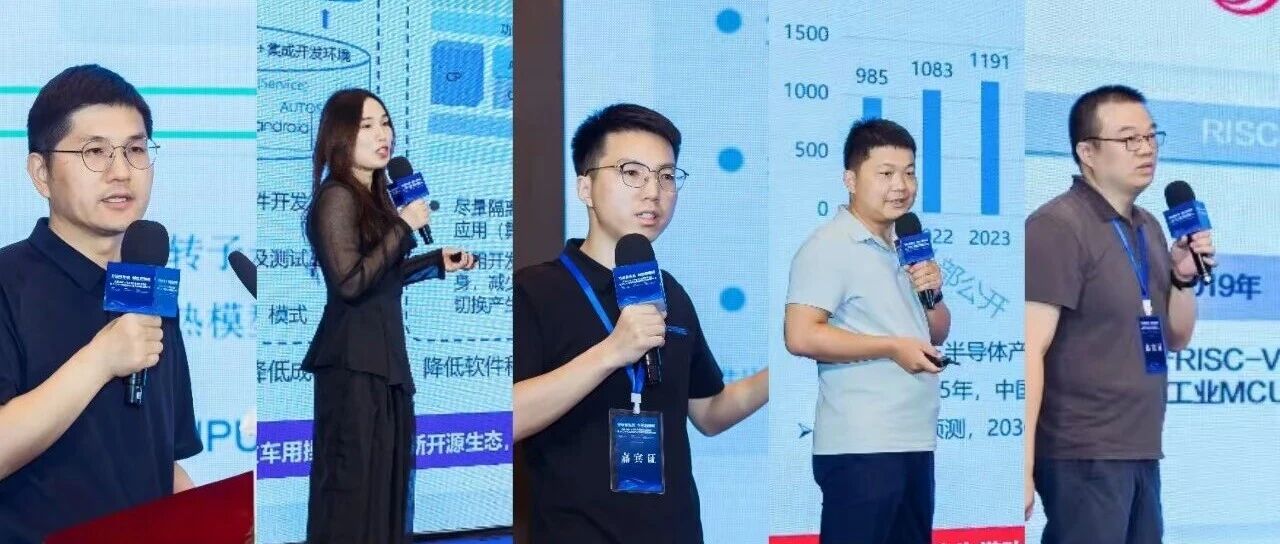
沙龙现场,来自芯来科技、芯原股份、复旦大学、妙芯微的技术专家们分享了在AI领域各方面的技术进展与成果实践经验。
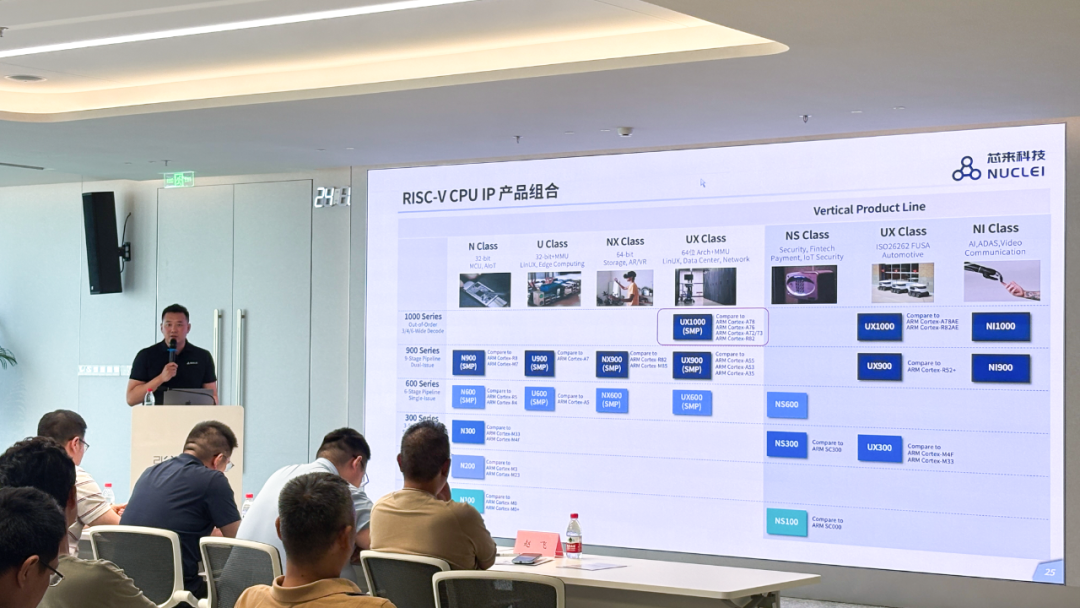
芯来科技技术专家范添彬展示了《AI SoC主控核心:AI芯片的RISC-V主控核(UX1000)》主题。围绕芯来科技UX1000作为AI SoC主控核的定位,展示UX1000系列各项性能参数。UX1000具备高性能、高可靠等特点,能够满足AI芯片对主控核的多样化需求,助力客户实现高效系统设计。

芯原股份NPU/DSP产品高级总监毛夏飞带来了《AI SoC NPU加速器:芯原NPU IP》的主题演讲,系统介绍了芯原面向AI SoC的NPU IP组合。他表示,芯原VIP9X00系列NPU IP采用高度可配置、可扩展的架构设计,可满足不同算力需求,并通过灵活的多核配置实现性能扩展。新一代架构针对Transformer类模型进行了深度优化,并支持多种整数及浮点数据格式,可提升大模型推理效率。
截至目前,芯原NPU IP已被91家客户用于140余款AI芯片,累计出货约2.5亿颗,覆盖10余个应用领域,并已通过ISO 26262 ASIL B级汽车功能安全认证。在软件生态层面,芯原围绕AI模型高效部署,构建了覆盖模型转换、量化优化、编译及运行时的完整软件栈,并已支持Qwen、DeepSeek、LLaMA、Stable Diffusion、MiniCPM等多种大语言模型及AIGC与多模态模型,为AI模型在不同终端和计算平台上的高效部署提供支持。

芯来科技创始人胡振波带来《AI SoC算力核心:面向AI推理的专用RISC-V算力核(NI系列)》。芯来科技NI900与NI1000作为AI芯片算力核,内置多种加速单元,可高效承载AI推理负载,并与主控核协同工作,提升系统整体性能。

复旦大学陈迟晓教授在主题演讲《存算与3D堆叠:面向智能体/具身智能的三维存算容融合集成芯片》中指出,大模型产业重心正从训练向推理迁移,智能体推动下,Decode负载也显著加剧。演讲中分享了存算融合与三维集成技术,指出该技术可有效突破内存瓶颈,为智能体推理提供高能效硬件支撑,是未来重要发展方向。

芯来科技技术专家李海忠带来《AI SoC子系统:基于RISC‑V的定制子系统方案提升AI SoC前端效率》主题演讲。芯来科技子系统整合多种自研IP,可帮助客户缩短研发周期、降低投入成本,实现快速产品化,实现省钱、省时、省力,为客户带来高可靠性和成熟度的AI SoC子系统。
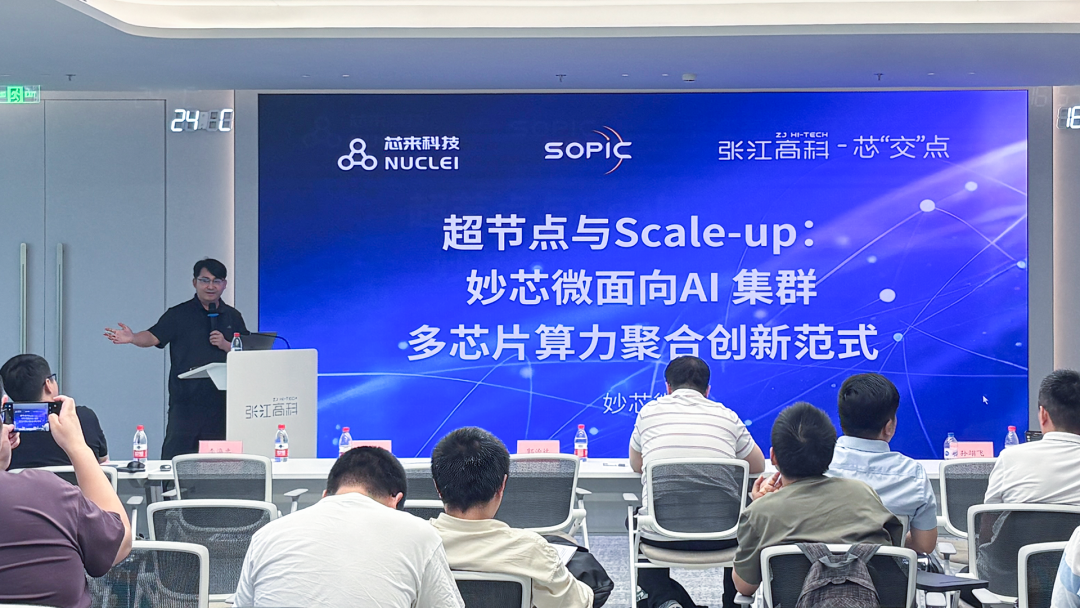
妙芯微创始人王东带来《超节点与Scale-up:妙芯微面向AI集群多芯片算力聚合创新范式》。演讲中谈到,摩尔定律与Scaling Law边际效益收窄,AI Infra转向效率主导。并介绍面向AI集群的算力聚合方案,指出超节点可有效提升多芯片协同效率,公司推出全栈产品,助力客户构建高确定性计算域。
本次沙龙串联了RISC-V AI芯片从底层IP到系统级方案的关键环节。主题分享之外,交流会现场互动氛围热烈,大家就RISC-V领域热门方向进行了友好交流与探讨。
下周,RISC-V AI技术沙龙将来到北京站,结合RISC-V在AI领域的技术热点,系统性解答RISC-V为什么适合AI芯片场景,欢迎大家报名参加。
期待下一次相聚,共同见证RISC-V生态的持续繁荣。

▼往期精彩回顾▼