公众号记得加星标⭐️,第一时间看推送不会错过。
在AI算力的战火从单芯片性能迅速蔓延至集群互连的今天,高速互连战场迎来了罕见的剧烈震荡。
两支源自英特尔昔日网络业务的创业力量,在同一时间冲向了AI时代最值钱的Scale-up 互连赛道,并将矛头直指英伟达的腹地。另一边,由115家行业巨头组建的“反NVLink联盟”正在加速集结,试图打破单家垄断;而英伟达则顺水推舟打出“NVLink Fusion”这张暗牌,试图在硬件层重演CUDA的封神之路。
一场关乎下一代AI数据中心主导权的硬件大决战,已经全面打响。
两个英特尔旧部,冲向同一个战场
首先让我们来看下Cornelis这家公司,它和英特尔的渊源很深。2020年,英特尔将 Omni-Path Architecture(OPA) 高性能互连业务拆分,核心团队成立 Cornelis Networks。Cornelis CEO Lisa Spelman本人此前也在英特尔工作约20年。直到今天,Cornelis仍然明确将自己描述为“从英特尔高性能互连业务拆分而来”,其技术路线也直接继承了Omni-Path。Omni-Path当年原本就是英特尔用来挑战Mellanox InfiniBand的重要武器。
只不过随着Intel战略调整,这项业务最终被剥离出去。而此后几年,Cornelis一直围绕HPC和AI集群发展自己的高速互连产品。目前已经量产的CN5000仍然主要解决Scale-out问题,也就是服务器、计算节点之间的大规模连接。其交换机提供48个400Gb/s端口,Director级设备最高可以提供576个400Gb/s端口。
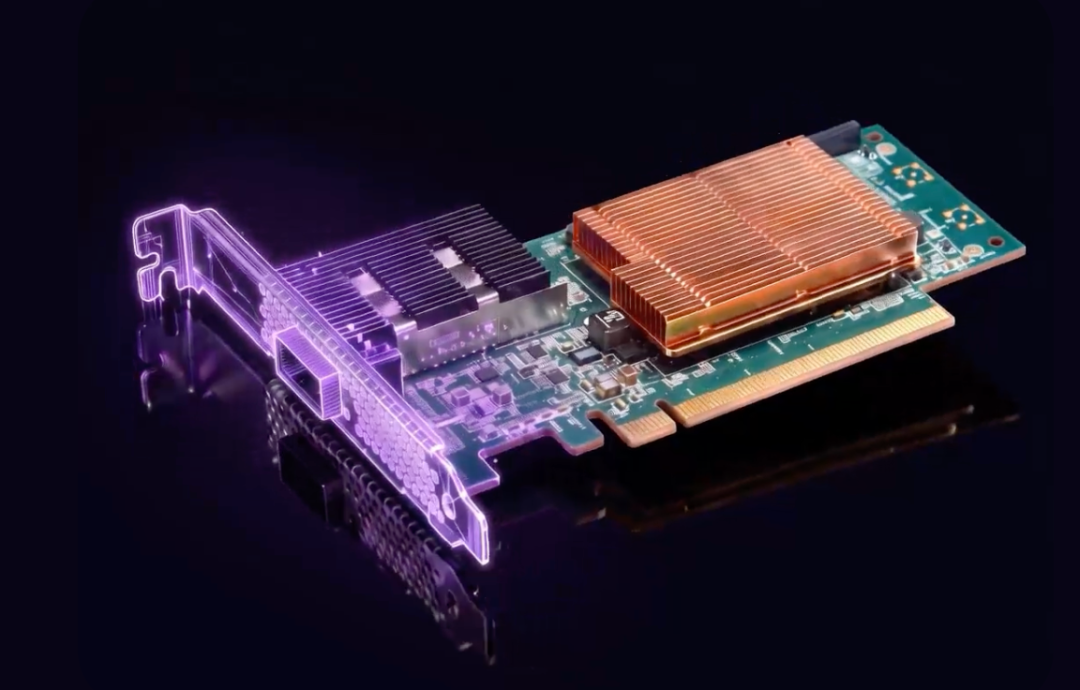
但9月14日这次融资之后,Cornelis明显跨过了一条边界。它第一次正式宣布进军Scale-up。
所谓Scale-out,是把更多服务器连接起来;Scale-up则更加靠近GPU本身,要让一个机架里的几十甚至数百颗AI加速器像一台计算机一样协同工作。而这恰恰是NVLink长期占据优势的位置。
9月14日,Cornelis宣布融资2.05亿美元,并发布 Active Compute Fabric(主动计算网络)——一种集成可编程计算、跨横向与纵向扩展的开放网络架构,标志着其正式进军纵向扩展网络领域。Cornelis想做的是:让网络本身开始计算该架构将无损传输、网内加速与可编程计算融为一体。它能在数据流动时直接处理数据、卸载集合通信并适应AI算法演进,避免GPU因等待数据而停顿,大幅提升加速器利用率。
Cornelis声称,在10万张GPU的集群中,传统网络因数据等待会导致约50%的算力空转,每年浪费近16.8亿美元及500 GWh电量(够近4.8万个美国家庭用电)。Active Compute Fabric通过网内计算解决这一痛点,并兼容UALink、ESUN及Ultra Ethernet等开放标准与主流加速器。
几乎在同一时间,另一家英特尔系背景的初创公司Delos Data也发布了融资消息。
Delos Data的CEO兼联合创始人Ed Doe同样来自Intel体系。这家公司是2025年成立的新公司,由Ed Doe和Dan Daly创办Ed Doe曾任Barefoot Networks COO。英特尔 2019年收购 Barefoot 后,他先后负责英特尔Barefoot Division、英特尔 Switch & Fabric Group等业务。Dan Daly同样是英特尔老将,曾长期担任英特尔网络领域高级工程职务。路透社把Delos 定义为一家由“英特尔 veterans”创办的公司。
Delos在9月15日宣布融资超过1亿美元,投资方包括Matrix、Playground Global、Capricorn、Matter Venture Partners等,值得一提的是,前英特尔CEO Pat Gelsinger现在所在的Playground Global也参与其中。
Delos提出了一个概念:MoXI(Mixture of X Infrastructure),也就是“混合一切”的基础设施。它正在开发的Nonstop AI Data Interface,本质上是想在这些异构设备与网络之间增加一个统一数据接口。例如,其面向GPU、XPU和AI加速器的I/O Chiplet计划直接与计算芯片共同封装,可以提供超过30Tb/s的多协议I/O带宽;此外还有超过10Tb/s的近封装光学版本,以及面向CPU、闪存和内存的400Gb/s以上板卡版本。

图源:Delos
Delos不是简单的NVLink替代者。它的野心反而更大:如果各种GPU、XPU、内存和存储能够通过统一的数据接口自由组合,那么底层到底使用NVLink、UALink还是其它协议,就不应该再决定整个系统架构。
115家公司,
组建了一个“反NVLink联盟”
如果说Cornelis和Delos还是创业公司的进攻,那么真正能够从产业层面对NVLink形成制衡的,是UALink(Ultra Accelerator Link)。
UALink最初由AMD、Intel、Google、Meta、Microsoft等共同推动,目标建立一个开放的AI Scale-up互连标准。截至2025年底,UALink Consortium成员数量已经超过115家。今天UALink董事会中除了AMD和Intel,还包括谷歌、Meta、微软、AWS、苹果、阿里巴巴、思科、HPE、Astera Labs以及Synopsys等公司。可以说,UALink的成员基本覆盖了今天全球最重要的云计算公司、AI芯片公司和基础设施厂商。

UALink 1.0支持200G/lane,并可以在一个AI Pod内连接最多1024颗AI加速器;2026年4月发布的新一批规范又加入了In-Network Compute、Chiplet、集中式管理等能力。9月初,UALink进一步披露下一阶段路线图,明确开始推进400G、光互连、端到端可靠性以及更丰富的管理功能。
对于这些厂商而言,他们不希望未来所有AI计算芯片都必须经过英伟达的一道收费站。如果芯片实现了自研,最终机架内部的核心互连却仍然必须依赖NVLink,那么这种“去英伟达化”显然是不完整的。这就是UALink最核心的商业逻辑。
英伟达的绝妙反手:NVLink Fusion
英伟达也看到了这一点。于是2025年5月,一个非常关键的变化发生了。英伟达推出了NVLink Fusion——一种新型芯片,它使各行业能够利用英伟达的NVLink构建半定制的AI 基础设施。

2025年以前,NVLink很大程度上是英伟达内部GPU之间的私有高速互连。NVLink Fusion却第一次系统性地向第三方CPU和AI ASIC开放。首批公布的合作伙伴包括联发科、Marvell、世芯(Alchip)、Astera Labs、Synopsys和Cadence;Fujitsu和Qualcomm则计划开发可以通过NVLink与英伟达GPU组成系统的CPU。
随后这个名单不断迅速扩大。2025年11月,Arm宣布Neoverse集成 NVLink Fusion。2025年12月,AWS宣布Trainium4 将集成 NVLink Fusion。2026年1月,SiFive的加入,意味着RISC-V CPU也可以进入NVLink。NVLink Fusion在极短时间内打通了 Arm、x86、RISC-V三大CPU架构。
2026年3月,作为首批NVLink Fusion合作伙伴,Marvell双方把合作进一步升级,英伟达还向Marvell投资了 20亿美元。Marvell将提供Custom XPU、NVLink Fusion兼容Scale-up网络、硅光技术,而英伟达继续提供NVLink、Vera、ConnectX、BlueField、Spectrum-X等。
更具戏剧性的是,就连英伟达的竞争对手也选择“投诚”。
2026年9月10日,作为英伟达的典型挑战者之一的AI推理芯片公司d-Matrix,宣布加入英伟达NVLink Fusion生态。按照双方公布的计划,d-Matrix下一代Raptor XPU将直接接入英伟达的机架级基础设施,与Vera CPU、NVLink Switch、BlueField-4 DPU、ConnectX-9 SuperNIC以及Spectrum-X以太网共同组成完整系统。首批相关系统预计从2027年开始部署。2025年,d-Matrix完成4.5亿美元融资,估值达到20亿美元。
一个试图从英伟达手里抢AI计算市场的芯片公司,为什么反而主动接入英伟达的NVLink?
因为NVLink Fusion给的实在太多了:成熟的Scale-up网络,不用重新开发;成熟的机架,MGX已经大规模部署;成熟的供应链,电源、液冷、主板、交换机、机箱都有人做;成熟的数据中心部署体系,客户已经都很熟悉;更重要的是更短的上市时间,这对创业公司尤其致命。
所以,笔者汇总了一下,目前英伟达明确列出的NVLink Fusion生态已经包括:(一)CPU阵营:Arm、英特尔、Fujitsu、SiFive;(二)ASIC / Custom Silicon阵营:世芯(Alchip)、Astera Labs、GUC、Marvell、联发科、三星、AWS、d-Matrix;(三)EDA/IP领域:Cadence、Synopsys;(四)光互连阵营:Ayar Labs、Lightmatter、Marvell。
从NVLink Fusion的名单中我们也可以看到一个现象,这里面不少厂商也在UALink。所以真实产业状态其实是芯片公司正在“两边下注”,这和PCIe、CXL、以太网的历史很像。它们一边参与UALink,帮助建立一个开放的NVLink替代生态;另一边又积极支持NVLink Fusion。
对这些公司而言,最危险的事情不是同时支持两个标准。而是押错标准,尤其对于接口IP、交换芯片、光互连、EDA厂商来说,最合理的商业选择本来就是:NVLink AND UALink,而不是NVLink OR UALink。
综合各方面来看,UALink vs NVLink,现在已经不是简单的开放与封闭的竞争。目前来看,英伟达凭借六代演进与从芯片到软件的深度打磨,拥有巨大的先发优势;而 UALink 虽有百家响应,但大规模商业落地仍需等待 2026—2027年的窗口期。

这场战争短期看并不是谁马上消灭谁。真正需要关注的是:UALink能不能把“开放”变成真正可部署的多供应商生态;而NVLink Fusion能不能趁着这个时间窗口,把越来越多第三方CPU、ASIC甚至竞争对手提前吸收到自己的机架体系里。
CUDA锁软件,
NVLink锁硬件基础设施
过去二十年,很多人都曾经认为:只要做出一颗性能接近英伟达的GPU,就有机会挑战英伟达。后来大家发现事情没有这么简单。因为客户使用的并不只是一颗GPU。它们已经把CUDA、cuDNN、NCCL、TensorRT,以及PyTorch背后的大量优化、开发工具和工程经验,全部建立在英伟达的软件生态上。
所以竞争对手真正需要迁移的不是一颗芯片。而是一整个软件世界。这就是CUDA最厉害的地方。
而今天,相似的事情正在硬件基础设施层重新发生。过去一家AI芯片公司只需要考虑我的芯片性能是不是比GPU更高,而现在则需要思考我的芯片装进谁的机架。因为AI系统的竞争单位,正在从Chip升级为System,再从System继续升级为Rack甚至整座AI Factory。
英伟达自己对此也非常明确。NVLink 6已经不是独立的GPU接口,而是和Vera CPU、NVLink Switch、ConnectX、BlueField、Spectrum-X、NCCL、Dynamo等软硬件进行深度协同。英伟达将这种模式称为把整个数据中心视为一个计算单元。
堵不如疏,在英伟达看来,与其试图阻止所有客户自研芯片,不如换一种玩法:你的芯片可以不是我的,但你的芯片可以接到我的平台里。通过 NVLink Fusion,英伟达成功将“芯片份额”与“平台份额”进行了解耦。即使未来第三方ASIC分走了一部分算力需求,只要它们依然跑在NVLink、MGX 机架和 Spectrum-X 网络之上,英伟达就依然稳坐AI基础设施的抽税者地位。
十多年前,CUDA让行业逐渐意识到,GPU最强大的地方不只是GPU。今天NVLink Fusion正在试图让行业再次面对一个类似的问题:英伟达最难替代的东西,未来也许不再只是GPU,而是GPU周围那整套基础设施。
CUDA锁住了软件生态。现在,NVLink正在向硬件基础设施延伸。不得不说,英伟达又打出了一手绝妙的好牌。
*免责声明:本文由作者原创。文章内容系作者个人观点,半导体行业观察转载仅为了传达一种不同的观点,不代表半导体行业观察对该观点赞同或支持,如果有任何异议,欢迎联系半导体行业观察。
END
今天是《半导体行业观察》为您分享的第4533期内容,欢迎关注。
推荐阅读
★
★
★
★
★
★
★
★

加星标⭐️第一时间看推送~





