8 月 28 日,第十二届张江高科·芯谋研究集成电路产业领袖大会分论坛在上海张江举办。分论坛分设两场——设备材料零部件分论坛与硅光和算力芯片分论坛,来自半导体产业链各环节的企业代表、专家学者齐聚一堂,围绕最新的产业趋势、前沿技术与市场走势展开深入分享。
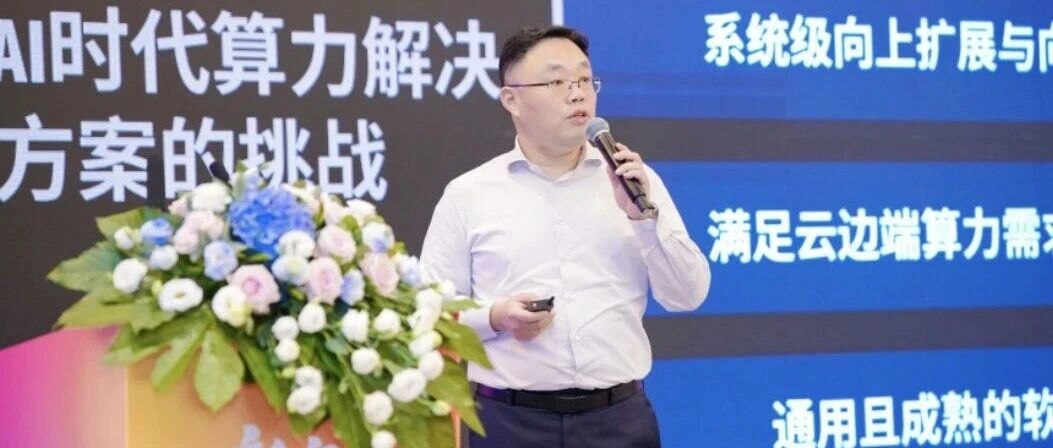
AMD 全球副总裁、中国研发中心总经理吉隆伟在硅光和算力芯片分论坛上做了题为《赋能 AI 时代:AMD 端到端算力解决方案》的精彩分享。
吉隆伟指出,AI Everywhere 正推动 AI 从数据中心走向千行百业和个人终端,并带动算力基础设施进入全面升级的新阶段。
当下 AI 正处在一个关键的转折点上——智能体 AI 兴起、企业部署从试点转向大规模落地、AI 运行在几乎每一台设备上。这三重变化对算力提出了从云端到终端、从硬件到软件的多维度新需求。
Agentic AI 正推动 AI 基础设施架构发生变化。随着智能体编排、工具调用、数据处理等 CPU 型工作负载快速增长,CPU 在 AI 数据中心中的重要性持续提升,吉隆伟认为,CPU 与 GPU 的资源配置有望从传统大模型时代的不对称架构逐步走向更加均衡的形态。
围绕 AI 时代算力解决方案的四大挑战——芯片、Scale up/Scale-out 系统能力、云边端多样化产品形态、通用成熟的软件生态,吉隆伟系统介绍了 AMD 的端到端布局。
在芯片层面, AMD采用先进封装与Chiplet设计,结合3D堆叠及HBM集成技术,持续提升计算性能、缓存容量和系统集成度。
今年发布的第六代 EPYC “Venice” 构建了覆盖企业、HPC、AI 和 Agentic AI 的多样化产品组合,针对性能、TCO、缓存与能效等不同需求进行优化,实现更高的计算效率与部署灵活性。
在系统互联层面,AMD 推动开放生态,采用 UALink 与 Ethernet 构建可扩展的 AI 基础设施架构,实现从节点内到集群级的高效互连。
在云边端产品层面,Radeon PRO W7900D 面向企业级集群 AI 推理,AMD 同时联合生态伙伴构建大规模 AI 算力平台,支撑企业级 AI 应用部署与全球开发者创新。
终端侧则以 Ryzen AI Max+ 395 为代表,集成 CPU、GPU 与 NPU 异构算力,将高性能 AI 能力带到边缘与个人终端,推动本地 AI 应用创新。
在软件层面,AMD 持续推进开源开放的 ROCm 平台,一套软件栈可覆盖 Ryzen AI、Radeon AI PRO、Instinct MI 与 EPYC 全部硬件,实现从云到边缘、从训练到推理的统一开发与部署。依托快速迭代的软件生态、主流 AI 框架支持以及开放的开发者社区,ROCm 正不断降低 AI 应用迁移与部署门槛,加速企业级 AI 创新与规模化落地。

“AI 的创新是一个全球性的集体努力。”吉隆伟最后表示,AMD 将与合作伙伴一起,持续推动整个算力技术的创新与 AI 的可持续发展。