
大模型竞争正在从模型能力本身,进一步延伸到算子、编译、通信和运行时等系统软件层。超大规模模型、长上下文和多模态不断抬高数据中心的计算与存储需求,轻量化模型又加速进入 AI PC、边缘设备和 ARM 平台;与此同时,GPU、NPU、CPU 等AI芯片日益多元。新的挑战已经不只是“有没有更多芯片可用”,而是模型与系统优化能否跨平台复用,让一次模型适配、一次算子优化和一次系统调优,沉淀为更多算力可以共享的能力 —— 这正是 AI 开放计算希望解决的问题。
9 月 30 日,众智 FlagOS 社区正式发布 FlagOS 2.2,沿着AI开放计算的技术路线持续演进,进一步拓展对多元 AI 芯片和前沿大模型的支持。目前,FlagOS 技术栈已覆盖多达 21 家 AI 芯片厂商,通过统一、开放的软件栈,让不同芯片共享模型适配、算子优化与系统性能提升成果,加速最新 AI 模型在多元算力上的高效落地。
更多算力选择:扩展训练、推理框架适配,增强 ARM CPU 路径
持续扩展 vLLM、SGLang、PyTorch、TE、Megatron等框架多芯片接入能力,其中vLLM-plugin-FL和SGLang-plugin-FL完整覆盖12 家芯片厂商,并首次独立发布 FlagTree-CPU,将 ARM 低比特推理所需的编译、算子与框架能力衔接起来。
更好发挥性能:算子快速扩展,编译优化、算子路由和调试能力增强
9 大算子库总算子数从 2.1 版本的 564 个,提升到 1454 个算子,首发 FlagGems-sglang 算子库共 40 个算子。统计接入量最大的 10 家 AI 芯片,跨芯片算子加速比中位数均值由 2.1 版本的 0.861× 提升至 1.099×,提升 27.58%,多芯片算子库性能已提升至整体超过基线水平,基于 FlagTree 编译器及 Triton-TLE 语言能力,大规模算子库在多芯片的整体性能优化取得了实质性突破。首个跨芯片编译器调试工具 FlagPrism 开源发布,同时支持 5 款芯片。
更容易部署使用:量化转换、测试验证、发布主流镜像模型
首次发布 FlagOS-Compressor 支持 W4A16/W8A16/W8A8,结合跨芯适配,为存量多种AI算力承接前沿模型提供更多部署选择。本季度 7 大新发布模型完成 Day 0 多芯适配,单模型最多覆盖 12 个芯片,FlagRelease 在魔搭/Huggingface等同步发布 300+ 模型镜像。
Part.01 多芯片适配再扩展:统一框架接入,完善训练与推理链路
推理插件与 Torch-FL 协同,扩大应用接入范围
vLLM-Plugin-FL 完成13款芯片的全量支持。 vLLM-Plugin-FL 在 FlagOS 2.2 版本同时提供对 vLLM-0.20.2及 vLLM-0.24.0 的支持,并陆续支持 vLLM-0.28.0。提供增强 Empty 模式部署路径,将框架构建与设备实现解耦,由插件承接硬件接入、算子和通信能力,减少按厂商维护框架分支的负担;同时补充 INT8/W8A8 接入、国产后端图执行和 KV 传输监控。
SGLang-Plugin-FL 支持 8 款芯片。 配合首次发布的 FlagGems-SGLang 专用算子库,补充 Empty 路径、流水并行通信、预填充与解码分离的 KV 传输,以及多 Token 预测接入。开发者可以在统一插件接口下,按硬件和模型选择经过验证的执行配置。
首次发布 Torch-FL 将多芯适配延伸到 PyTorch。 2.2 版本共支持了 8 款AI芯片,通过统一虚拟设备FlagOS与多路算子路由机制,连接 FlagGems、厂商实现和兼容路径,并增强混合精度、分布式运行及编译接入。Qwen-Image-2.1 的多芯片实践已经展示了这一方式的应用价值:在完成对应平台环境配置后,开发者可保留标准 Diffusers 推理接口,复用已有生成式应用代码。
训练侧,Megatron-LM-FL 升级至 MCore 0.18.2,TransformerEngine-FL 升级至 TE 2.17,补充 GLM5 系列 DSA 结构、融合 RoPE、分块交叉熵及后端适配。FlagScale 增加慢节点检测、训练性能监控、进度心跳和权重转换,完善长时间训练所需的运行管理。
下图表是FlagOS主要组件 × 芯片在 2.2 版本的适配全景图 (其中:绿色✓ 表示 2.1 已有,蓝色✓ 表示 2.2 新增)

端到端性能优化:把算子选择落实到模型表现
通过统一的算子接入与路由机制,开发者可以根据模型负载,组合使用 FlagGems 算子与vLLM插件,优化完整推理链路的吞吐与延迟。例如在 Hy3 的适配验证中,FlagOS 采用 FlagGems、vLLM-Plugin-FL 与 FlagTree 组合,并在相同软件栈下调整 FlagGems 算子的启用范围,仅启用 fused_moe、moe_align_block_size、moe_sum 和 exponential_ 四个算子,其余沿用原有推理实现。在 8 卡 NVIDIA H20、BF16、64 并发条件下,4K/1K、16K/1K、32K/1K 三种输入输出长度的测试结果显示,该配置较原生 vLLM 基线吞吐提升 3.2%—7.2%,P99 首字延迟下降 2.7%—3.1%。

Part.02 算子总量超过1400,多芯片整体算子性提升27%,超过原生基线
FlagOS 2.2 持续扩充通用计算、推理专用与科学计算算子,发布清单覆盖 9 个算子库。其中,FlagGems 等公开算子由 564 个增至 1454 个,新增 890 个。首次发布 FlagGems-SGLang,包含 40 个多芯片高性能算子。
新增能力面向模型中的实际计算需求:FlagGems 扩展线性代数、归约与训练反向接口;FlagGems-SGLang 覆盖 Attention、Mamba 状态更新、MoE、LoRA、采样与量化,本轮 NVIDIA 测试通过清单覆盖全部 40 个算子;FlagGems-vLLM 扩展 MLA、KDA/GLA/GDN2、TopK 与低精度计算,为推理框架提供可复用的专用算子。如下图是 9 大算子库在 2.2 版本持续扩容对比图

2.1 围绕关键计算路径,联合优化算子与编译执行
针对 Attention、MoE 和低精度计算,FlagOS 2.2 将算子实现与编译优化结合,减少数据搬运、内核启动和同步等待,并为不同输入形状选择执行路径。其中在 2.2 的版本上,FlagTree 主分支新增 AMD、进迭时空、平头哥,并引入可选的 NVIDIA TileIR 编译路径,扩展公共编译能力的适用范围,并提供以下编译与调优支撑:

经过持续优化,整体算子在 2.2 版本的到显著提升,以下是基于不同芯片厂商的算子加速比。在上千个算子、10 款异构 AI 芯片这一大规模基数上取得 27% 的整体提升,意味着 FlagOS 的优化能力正从单点性能突破,走向跨芯片、规模化的系统性能提升。

关键算子实测案例

TopK:A100-PCIE-40GB,输入 [64, 129280]、k=1024,耗时由 0.353280 ms 降至 0.130048 ms。KDA:H800、BF16、K=V=128、BT=16,12 组配置,两阶段计算链。两项为各自基线下的实测结果。
2.2 AI 辅助生成,扩展经过验证的算子供给
KernelGen 将算子生成、正确性验证与自动调优连接为开发流程,帮助开发者面向不同芯片实现和优化算子。本季度新增生成 765 个算子,416 个在至少 5 款国产芯片精度验证达标并达到原生算子性能 80% 以上;其中,在各平台达到对应原生实现 80% 以上性能的数量如下。

Part.03 新增 CPU 编译能力:让新模型在 ARM 平台高效运行
从本地智能助手到边缘应用,开发者希望在设备上直接完成推理,减少对云端调用的依赖,让数据留在本地。面对 ARM CPU 的内存容量、访存带宽与计算资源约束,FlagOS 通过低比特编译、专用算子和推理调度协同优化,拓展 AI PC 与边缘设备能够承载的模型范围。
在 2.1 已有 ARM 支持的基础上,FlagOS 2.2 首次将 FlagTree-CPU 作为独立编译组件发布。 FlagTree-CPU v0.1.0 基于 triton-cpu 3.7.2,增加面向 Arm64 SME2、SVE2 和 NEON I8MM 的编译支持,为 W4A8、W8A8 等低比特算子生成适合目标 CPU 的计算指令。配合 FlagGems 的 ARM CPU 算子库,并通过 vLLM-plugin-FL 将低比特计算和优化算子用于模型推理,支持模型在 ARM CPU 上高效运行。
针对 Prefill 和 Decode 优化计算与调度。 在 Qwen3.8-27B、MiniCPM5-2B 等模型上,FlagOS 通过权重预打包、算子融合和已编译内核复用,优化提示词处理阶段的矩阵计算与逐 Token 生成阶段的权重访问;同时,根据单流推理的特点优化线程配置与任务调度,减少不必要的同步和调度开销。对于 Xing4.0 的 MoE 结构,进一步优化专家路由、计算调度和共享专家融合。
近期 ARM Day 0 适配已覆盖轻量语言模型、百亿参数稠密模型、MoE 模型和文生图模型。 在完成适配后,FlagOS 持续优化各模型的推理性能,当前发布版本的配置与实测结果如下:

测试说明:推理部署硬件使用 Apple M5 Pro、64 GiB 内存、纯 CPU、单流配置,测试包含 512 Token 输入与 128 Token 输出。Xing4.0 关闭 MTP;其端到端吞吐为输入与输出 Token 总数除以请求耗时,vLLM 0.24.0 开箱基线为 33.19 tok/s。
从模型适配延伸到部署入口。 开发者可通过上表模型卡获取量化权重、运行环境要求和部署说明;FlagTree-CPU v0.1.0 同时提供面向 Mac M5 Pro 的 Qwen3.8 部署脚本,串联模型准备、环境安装、推理与基准测试,让已有 ARM 优化成果更容易被复用到本地应用中。
项目地址:github.com/flagos-ai/flagtree-cpu
Part.04 首次发布FlagOS-Compressor:统一跨芯片量化,让存量算力承接前沿模型
智算中心的算力基础设施按多年周期建设,而模型规模与精度格式持续演进。能否用已有设备部署新模型,直接影响服务器利用率和硬件投资的长期回报。FlagOS 通过量化、算子优化与跨芯适配,在部署条件、模型精度和运行性能经过验证的基础上,拓展存量算力能够承载的模型范围,为延续硬件投资价值提供更多选择。
FlagOS 2.2 首次发布 FlagOS-Compressor,为跨芯片部署提供统一的权重转换与量化工具。 面向万亿参数级 BF16 模型,通过 INT8/INT4 量化减少权重占用与搬运量,缓解显存和带宽约束;面向 FP8、MXFP4 等低精度及混合精度权重,支持格式转换并重新量化为 INT8,使具备相应 INT8 算子与部署条件的存量设备获得运行新模型的更多选择。权重解析、策略配置、转换量化、产物导出与校验由统一流程完成,减少按模型、按芯片重复适配的工作。

按模型结构选择量化范围,兼顾压缩与模型效果。 FlagOS-Compressor 可直接读取 Hugging Face safetensors 权重,识别源精度格式与模块类型,并按 Attention、MLP、MoE 路由专家和共享专家选择或排除量化范围。对于多模态模型,可量化语言网络,同时让视觉编码器保持 BF16;embedding、归一化与路由门控等敏感模块也可保留高精度。在选定量化范围后,开发者可按部署需求选择以下方案,并将选择规则与量化参数保存为可复用配置:

从量化权重到推理就绪产物,减少跨芯片迁移中的手工适配。 工具将量化权重、缩放参数、分片索引与运行配置一起导出,生成 compressed-tensors 标准产物,并检查张量、索引及量化配置的完整性。MoE 专家权重的组织与推理所需命名也在导出阶段处理,减少手工改名、补配置和再次转换的步骤。配合 vLLM-Plugin-FL、FlagGems 等组件,开发者可按目标硬件选择配套推理配置,将统一的量化流程衔接到不同芯片的执行路径。
2.4T MoE 实践:以 INT8 路径支撑超万亿模型跨芯片部署。 在 Qwen3.8-2.4T-A95B 适配中,FlagOS-Compressor 提供 BF16、FP8 原生权重到 INT8 的两条处理路径;W8A8 对选定模块的权重和相应激活采用 INT8,为超大规模模型提供低精度执行方案。
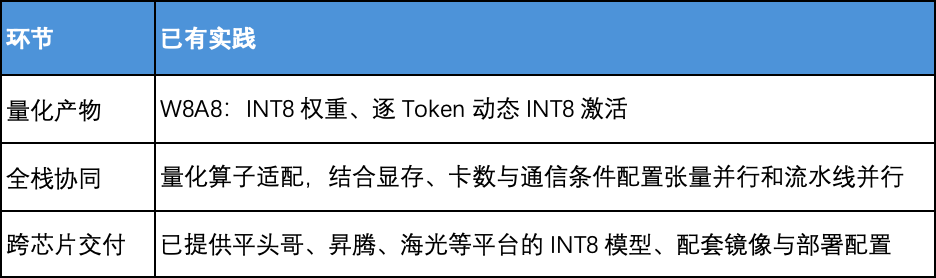
397B MoE 实测:模型体积减少 49.1%,完成双平台推理验证。 在 Qwen3.5-397B-A17B 适配中,FlagOS-Compressor 对 Attention 和 MoE 专家网络执行 W8A8 量化,视觉编码器保持 BF16。验证覆盖模型体积、任务效果与跨芯片推理:

GitHub地址:github.com/flagos-ai/FlagOS-Compressor
Part.05 首次发布FlagPrism:用统一调试工具提升跨芯片算子开发与调优效率
算子调优的前提是“看得见”:计算结果在哪里出现偏差,运行时间消耗在哪里。过去这种设备侧观测能力被锁在各芯片厂商的私有工具里——换一款芯片就要换一套工具、一套概念、一套工作流,跨芯片算子开发因此长期处于“半盲调”状态。FlagOS 2.2 发布 FlagPrism(github.com/flagos-ai/FlagPrism),首次实现跨芯片的 Triton 算子 Debug 与 Profiling。

它作为 FlagTree 的子模块与编译器深度集成,在编译期和运行期两级观测 Triton kernel,把 Triton 源码、编译器 IR 操作与设备执行事件关联成同一条证据链,让开发者在英伟达 GPU 和各类国产 AI 加速器上使用同一套观测工作流。
FlagPrism Debugger
深入 @triton.jit kernel 内部的选定区域,采集中间值、数值摘要、访存地址信息乃至完整张量数据,并对应到源码语句和 IR 操作——数值偏差可以直接定位到语句级
FlagPrism Profiler
记录调用上下文、执行时间线、操作计数与访存字节估计、硬件指标及厂商 Profiler 数据,聚合为调用树、时间线等多种报告——计算、同步、数据搬运瓶颈一目了然
架构上,FlagPrism 把“开发者想观察什么”与“每个后端如何采集”分离:Debugger 与 Profiler 在所有设备上提供一致的概念和工作流,新增一个芯片后端只需实现采集层,对用户程序保持低侵入。工具自带 121 个Triton 算子的统一测试集(含输入与 CPU 正确性基准),保证跨后端行为可复核。目前已经支持华为昇腾、天数智芯、摩尔线程、英伟达、燧原等后端,后续硬件覆盖将通过统一接口持续扩展。
GitHub地址:https://github.com/flagos-ai/flagprism
Part.06 面向 AI Agent 与量智融合,持续拓展开放计算
KernelGen:让 AI 持续参与多芯片算子的开发与优化。 面向模型迭代和跨芯适配带来的算子开发需求,KernelGen 将代码生成、测试验证与性能优化衔接到真实仓库的开发流程,帮助开发者减少重复实现与调优工作。本轮 FlagGems 版本迭代中,已有 436 项带有 KernelGen 标记的贡献 PR,让生成与优化能力持续积累为社区可复用的代码成果。
KernelGenBench:随着 AI 更多地参与开发,评估生成结果也需要同时关注性能收益与生成成本。配套的 KernelGenBench 通过多芯片性能基线、Token 用量分析和防作弊检查,为不同生成方案提供可比较、可复核的评测依据,帮助开发者判断优化效果与投入,持续改进算子生成和调优流程。
FlagQuantum:是一个 PyTorch 原生的可微量子计算与量子 AI 框架,支持状态向量、MPS、张量网络及多 GPU/多节点分布式模拟,并可将同一套量子线路衔接到编译、训练和实验性真机执行流程。它的特色是让开发者像训练神经网络一样训练量子模型,并面向大规模模拟与国产异构加速器扩展。
2026 年 10 月 17—18 日,2026 人工智能开放计算大会暨众智 FlagOS 技术大会将在北京中关村国家自主创新示范区展示中心举行。 大会将进一步展开多芯系统、端侧推理、AI Agent 和量智融合的技术讨论,并安排实操工作坊。
请查看大会议程与踊跃报名:https://www.bagevent.com/event/FlagOS2026
Part.07 从适配到交付:质量验证、模型资源与社区共建
7.1 在真实模型和运行配置中验证
FlagOS 2.2 实现测试覆盖范围的全面提升,完善了多场景验证的能力。覆盖范围上囊括了算子数值精度,训练推理插件基础能力,模型训练和推理的能力,多芯兼容性适配等。具体的端到端环节上,包含模型训练、权重保存与转换、训练恢复、模型保存、模型推理、部署服务压测等环节。截至 9 月 30 日,发布质量主统计中的 99 个问题已解决 95 项,其中68 个 P0 问题全部解决。
7.2 用 Day0 适配验证复用能力,按芯片交付模型与部署资源
本季度,FlagOS 持续将统一软件栈用于新模型的首日多芯适配:从 2.4 万亿参数 MoE、混合注意力和多模态模型,到端侧模型与图像生成,适配中形成的算子、量化与框架能力不断沉淀为公共组件。截至发稿FlagOS单季度已经支持了 7 个模型的Day0案例,单模型最多覆盖 12 个平台/设备:

这些案例把“更容易部署使用”落到了可复用的交付路径上: Qwen-Image-2.1 经 Torch-FL 接入,开发者可保留标准 Diffusers 推理代码;MiniCPM5-2B 与 Xing4.0-29B-A4B 提供 ARM 低比特版本;各平台的模型卡说明环境依赖、模型路径和启动参数,帮助用户从已有方案开始部署。
FlagRelease 已经发布了 300 多个模型镜像,按芯片、精度与部署方案提供模型资源。这些条目包含同一模型的不同适配版本。开发者可以在 HuggingFace、魔搭及焕新社区查找模型卡与部署说明,并按目标硬件选择软件环境。

7.3 开源协作爆发持续增长
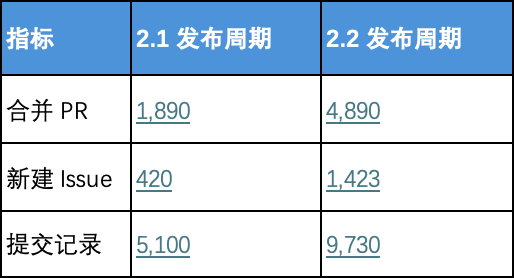
从框架插件、编译器后端到算子测试,FlagOS 的演进来自社区持续贡献。按 GitHub flagos-ai 组织统计,2.1到2.2发布期间,总共合并 PR 数量达到原来的约 2.6 倍,代码提交接近翻倍,开发贡献与社区反馈同步增长。
Part.08 鸣谢
FlagOS 从第一天起就是社区驱动的开源项目。FlagOS 2.2 的每一步向前,都凝聚着开发者、科研团队、芯片厂商与生态伙伴的共同投入。感谢大家在编译器与语言扩展、通用及融合算子、多芯片框架适配、跨芯通信、模型训推优化和自动化工程建设中的持续贡献——从一个算子的精度修复,到一条编译路径的性能优化;从一次跨芯片适配,到一套可复现的测试与交付流程,正是这些具体而扎实的工作,让“一次开发,多芯运行”不断走向更多真实场景。
特别感谢各高校、科研院所和企业团队带来的技术积累与工程实践,感谢芯片生态伙伴和开发者围绕多元硬件持续开展适配与优化。也感谢每一位参与代码提交、问题反馈、测试验证、文档完善和代码评审的社区成员。开源协作的价值,不只在于一次版本发布,更在于让每一次改进成为整个社区可以继续使用、验证和完善的共同成果。
参与贡献的单位与团队
以下单位与团队根据本期 PR 及贡献账号的公开资料、项目署名整理,排名不分先后。
高校和科研院所:北京智源人工智能研究院(BAAI)、中国科学院信息工程研究所、中国科学院大学、中国科学院计算机网络信息中心、光明实验室(人工智能与数字经济广东省实验室)、清华大学、北京大学、北京航空航天大学、北京科技大学、北京邮电大学、北京师范大学、北京工业大学、中国人民大学、南开大学、湖南大学、重庆大学、郑州大学、西安电子科技大学、西北工业大学、华南师范大学、沈阳大学、天津财经大学、中国地质大学(武汉)、加利福尼亚大学圣迭戈分校。
企业单位:水木羽林、中科加禾、杭州先进编译科技有限公司、硅基流动、湖大卡姆公司、河南昆仑技术有限公司(超聚变)、中移动研究院(芯合)、中电信人工智能科技(北京)有限公司、澎峰科技、清程极智、面壁智能、基流科技、晶隆智算、趋境、软通动力、鼎新、天宽科技、百度、Z.ai、阿里云、腾讯云。
芯片厂商:平头哥、摩尔线程、沐曦、昆仑芯、海光信息、寒武纪、华为、天数智芯、清微智能、辉羲智能、燧原科技、曦望、进迭时空、此芯科技、英伟达、AMD、壁仞科技。
合作社区:vLLM、SGLang、PyTorch、Megatron-LM、VeRL、TransformerEngine、Triton、Linux 基金会、Pytorch基金会、Eclipse 基金会、ModelScope(魔搭)、HuggingFace、腾讯教育、ITU-T、超算互联网中心、焕新社区。
贡献者名单:向所有在2.2版本开发期间在 FlagOS GitHub 组织提交并合入 PR 的所有264位贡献者致谢,直接贡献者数量比2.1版本增加了55%。按 GitHub 账号字母顺序排列,排名不分先后。
0songHan、0x45f、103yiran、ABan12、AdvancedCompiler、Al2O3Al2O3、alex-spacemit、AlexMa616、alexshuang、appleinsky、ArashiFeng、AriesMTR、armstrongttwalker-alt、Artlesbol、Ason93、at0rp1d0i-cell、awayzjj、bagpipe1289、baoqiliu、bin913、BingGeX、bwbwzzz、c2flowDS、Caeruleann
Caozhou1995、cccxxttt、ceci3、chaaa-a、cheersluvs、chen98038、cheng874、chenkc2025、chenmiao1919、CherryLemon、ChijinZ、chongzhouyang、chx7514、cjh9368、cjwystz、CLYtou、Cocytus486、CoyeCHEN、creaspoggg、cyber-pioneer、cyx11111、czy1101、DannyP0、Darryl233
dawnyang050-debug、Dayrker、Dingxingdi、dongjibin1996、Dongxu-H、douxetpur、EF-Knight、EF-TY、elllzat、ethanZZZZZZZZZZZZ、Eziotic、f-theworld、factnn、fanfanfanWu、fanmeng-123、FatJhon、Fattysand、FENGZIYI0711、finneyyan、FlagQuantum、fpzh2011、freaking-man-in、Galaxy1458、gao0624
gavin0x01、ggbondbest、Ghd-2077、ghl0808、git-flyer、HAi-WORLD、hangglider5、Hchnr、heavyrain-lzy、hellojack163、henghengxiedaima、HenryRenYz、HermiaHuan、hooray03、huanghaoXcore、huangxu0914、huangyiqun、huatuoli、hulong02-klx、huxinxin04-kunlunxin、i3wanna2、iflytek2026、isaname、iteratorlee
Jacob-yen、Jennie1004、JerryJonny、jia-heng、JiaryCoder、Joiin0392、Jonahmoon、JosephNew、July-h5kf3、k6699k、Kafka-Hatsune、kateyijian、kayzee3327、Keriza、kevinzs2048、KingsleyLiu-NV、kkkwb、kuoihao、Kylin1207、lauuyx-png、laylowch、Lee-mogul、legilla、lelongmask-cmp
lentil1016、leoda1、li199959、Liam-461-Lee、lihongyang1990、LiJunscs、limylily、liquanfeng、littlekid-zxt、LittleShun1214、liuhaoyutz、liuhycs、liuxiao0909c、liuxin2560、liuyancong-enflame-tech、lizhangyu258、llaboon、LoserCheems、ltllt1、lukatao、luojung、luoyc123、lusunn111、lvxu2020
lvyufeng、lxd-cumt、Lxiparer、lyujheng、lzllx123、lzy-edu、macqueen09、MC952-arch、Mike7180、mikethegoblin、modao1234、monellz、msgaofc、NCIC-AlphaSparse、neoskypig、NineAnnAnn、Onisen7、Oslomayor、PangJieLong、ph0375、physics31415926、Postroggy、qqjxzxq、Quamaly
rainlyxp、rdzhu225、rikyaa、RobertLuobo、rye985、Salamanca001、Salvationhope、Sawyer117、Seattle1917、shallitbeso、shanyulu、ShawnLiuxinghong、ShawnsYing、shenyu234、shh2000、shiptux、songdejun、Stardep-lmc、stringl1l1l1l、sunge666-ui、sunnycase、superwjfeng、taozhiwei、tengqm
Tiannn967、tianxiao-baai、tianyi-dialect、truong-v、tsingmicro-public-e、tspyc072、uesrshihe、Vincent-Xiao、w1120029931-bit、wangjiahui-99、wangxshuai、wangziy1、wbavon、wcleungaj-70、wenqingqian、WhatGhost、Willing2329、winfan1314、WorldPeace123、wuhansky、wuhulalala、wuwentao、wyNomad、XavierGithub
xdali-adora、XDYuanzhuLee、xinxin12345、xmhubj、xuanzhengdu-eng、xufeng102403、xup16、xzliu-opt、YangLong114514、Yangyang0906C、YaooXu、yilongma0110、yixiaodapeng、ymmyys、youseeyouonedayday、yswang777、YUANXIGUREN、YufanPeter、Yukun-Cui、yunyiliu、YY4994、yysheng26、yzw1128、yzw234
zacliu2023、ZenithJoyH、zeroherolin、Zhang-kg、zhangjieBaai、zhangnju、zhaojs12345、zhaoning999、zhaoyinglia、zhendongmiao、zheng1、zhengzihaoPKU、zhenxin8916、zhongsanming、zhoubo567、zhujiaxiaowang、zhzhcookie、zihaomu、zikong20、ZQ-Struggle、zuoweixia497、zykwqs、zyq1105331849、ZYX223

FlagOS 2.2 · 264 个贡献账号 · 2026-07-01—2026-09-28
FlagOS 2.2 版本官方下载渠道
用户可以访问FlagOS官网(https://flagos.io/resourcedownload)获取 FlagOS 2.2 版本镜像,注册后可以直接下载,覆盖相关的芯片的镜像版本。

关于众智FlagOS社区
为解决不同 AI 芯片大规模落地应用,北京智源研究院联合众多科研机构、芯片企业、系统厂商、算法和软件相关单位等国内外机构共同发起并创立了众智 FlagOS 社区,目前已经有 100多家成员单位。
FlagOS 是一款专为异构 AI 芯片打造的开源、跨芯系统软件栈,支持 AI 模型一次开发即可无缝移植至各类硬件平台,大幅降低迁移与适配成本。它包括大型算子库、跨芯AI 编译器、并行训推框架、跨芯通信库等核心开源项目,致力于构建「模型-系统-芯片」三层贯通的开放技术生态,通过"一次开发跨芯迁移"释放硬件计算潜力,打破不同芯片软件栈之间生态隔离。
官网:https://flagos.io
GitHub 项目地址:https://github.com/flagos-ai
GitCode 项目地址:https://gitcode.com/flagos-ai
SkillHub: https://skillhub.flagos.io
往期推荐



