英特尔® GPU D系列、英特尔® 至强® CPU、开放软件及生态创新,帮助客户实现智能体AI的大规模部署。
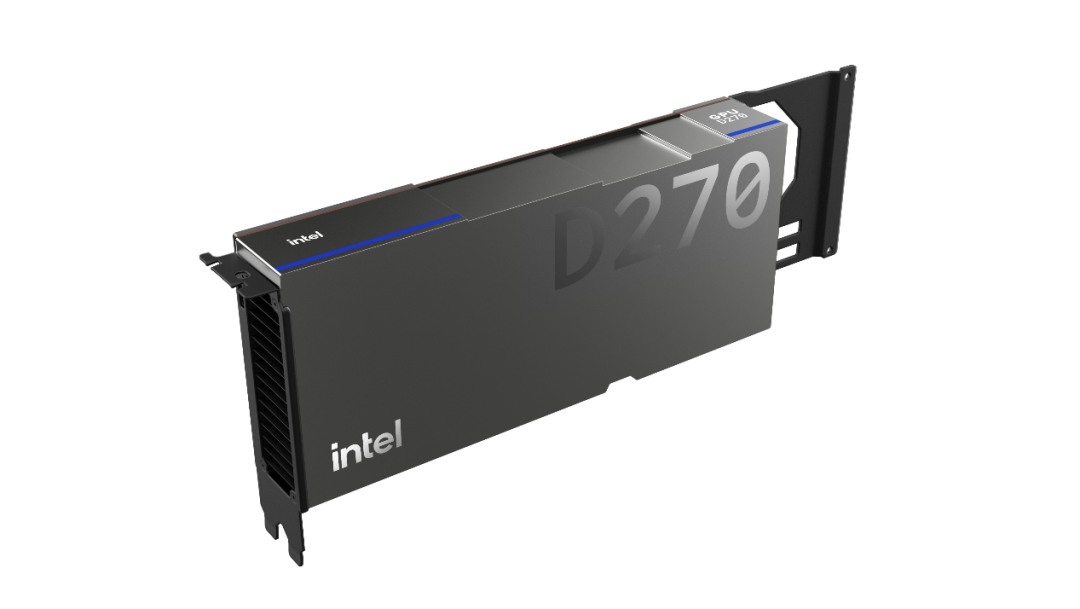
代号为Crescent Island的英特尔GPU D系列基于英特尔Xe3P架构,专为AI推理工作负载而打造。该GPU提供高达480GB的LPDDR5X内存、1.5TB/s内存带宽以及1.3 PFLOPS FP8算力,旨在提升持续运行的内存密集型AI推理工作负载的成本效益。
在开放计算项目(OCP)全球峰会上,英特尔披露了英特尔® GPU D系列(代号Crescent Island)的最新技术细节,介绍了基于英特尔® 至强® 处理器的全新整机柜设计,并展示了在开放软件与生态系统建设方面的最新创新成果。
在开源模型重塑智能体AI成本结构的背景下,市场需求愈发偏重于部署灵活、能效出色且兼顾成本效益的基础设施。这些技术进展,进一步强化了英特尔构建开放式异构AI基础设施的布局。通过将通用计算、专用加速、开放软件与标准化系统相结合,英特尔可以帮助各类AI工作负载实现性能与效率的全面提升。
从检索、推理、编排、工具使用到执行,智能体AI正将推理转化为复杂的多步骤工作流,这也让x86 CPU重回核心位置。与此同时,虽然开源模型赋予企业更多选择,但功耗限制、内存瓶颈和成本压力依旧突出,规模化部署AI逐渐演变为一项系统级挑战。
满足这些需求,需要一套易于部署和管理、开箱即用的异构基础设施。在成熟的x86软件生态的基础上,英特尔整合CPU、GPU和专用加速器,通过开放、可互操作的软件,让计算资源与任务需求实现更优匹配,从而提升整个工作流的整体利用率、性能和效率。
开源模型为企业部署AI带来了更多选择,但要想真正释放其全部潜力,关键在于,企业需要根据不同工作负载的特性,为其匹配适合的智能能力、计算资源和成本投入。这就是‘让每个AI请求都各得其所’的真正含义所在。
——Nicolas Dubé
英特尔公司副总裁、数据中心系统与解决方案事业部总经理

英特尔至强处理器:智能体AI的算力基石
在峰会上,英特尔展示了基于至强的全新整机柜设计,该设计由英特尔携手生态合作伙伴共同打造,可充分满足智能体AI日益增长的计算需求。其中,多项设计采用了开放计算项目Open Rack v3(ORv3)标准,进一步简化了客户在开放数据中心基础设施中的部署和集成过程。

英特尔携手生态伙伴展示了基于至强的全新整机柜设计,可支持智能体AI的工作负载。多项设计采用了开放计算项目Open Rack v3(ORv3)标准,为客户提供基于开放式模块化设计的即插即用型基础设施。
智能体工作流的复杂度日益提升,对通用计算也提出了更高的要求。无论是编排工作负载、处理数据、管理I/O,还是执行任务,都需要更强大的通用计算,来保持加速器的高效运转。为满足这些需求,特定的至强6+配置可在133.45 kW的总机柜功率下,实现单机柜超过46000颗核心的部署,以出色的CPU计算密度,为大规模智能体AI的应用提供强劲支撑。
依托二十余年整机柜的创新积累以及成熟壮大的x86软件生态,至强为智能体AI的大规模扩展提供了高密度的通用计算基石。当至强与GPU、专用加速器协同,开展编排工作负载、执行任务、管理数据传输等工作,整个系统将会保持高效运转。随着AI基础设施的持续演进,衡量性能的标准正逐步转向在目标延迟下,单个机柜能够支撑多少并发智能体的运行。而通过保障数据高效流转、工具顺畅调用以及为加速器持续供应资源,至强能够为客户带来更高的实际业务产出。
英特尔GPU D系列:专为高效大规模推理而设计
英特尔GPU D系列(代号Crescent Island)专为持续运行的内存密集型AI推理工作负载而打造,旨在提升此类工作负载的成本效益。英特尔GPU D系列基于英特尔最新Xe3P架构,在350瓦功耗范围内,可为用户提供高达480 GB的LPDDR5X内存、1.5 TB/s内存带宽以及1.3 PFLOPS FP8算力。这一产品充分兼顾了内存容量、计算能力与能效表现,体现了英特尔围绕真实推理场景持续优化基础设施的思路。
面向大语言模型、长上下文工作负载和高并发推理服务,单张英特尔GPU D系列最高可支持3000亿参数模型的运行,八卡系统则可支持超过1万亿参数模型的运行。其应用场景涵盖多租户AI服务、机器人以及其他对低延迟要求较高的工作负载。
英特尔GPU D系列采用标准的PCIe外形规格、风冷设计以及通用的Xe软件基础,可简化在现有数据中心环境中的部署,并支持应用在不同英特尔GPU平台之间灵活移植。这一设计,让客户无需再部署专用机柜或冷却基础设施,即扩展推理能力。
推理正成为AI领域的核心工作负载,企业需要能够在性能与成本之间取得平衡的基础设施。有了英特尔GPU D系列,高容量推理将会更易部署,并以更低的成本实现规模化扩展。
——Anil Nanduri
英特尔数据中心事业部副总裁、AI产品与市场拓展业务负责人
目前,英特尔正与OEM、ODM、专业AI云基础设施服务商(neoclouds)、独立软件开发商(ISV)、硬件设备提供商以及AI原生企业在内的广泛生态系统展开合作,推动英特尔GPU D系列的性能优势更快地转化为实际价值。这些合作聚焦于经过验证的平台、软件集成和可直接部署的解决方案,降低了客户的使用门槛,帮助其更快地实现从模型评估到实际应用的跨越。

英特尔重点介绍了不断壮大的生态系统,聚集了支持英特尔GPU D系列的广大客户与合作伙伴,涵盖OEM、ODM、专业AI云基础设施服务商、软件提供商以及AI原生企业。许多企业均为开放计算项目(OCP)成员,致力于提供经过验证、具备互操作性的AI基础设施,以及可直接部署的解决方案。
目前,客户送样工作正有序推进,英特尔将继续扩展硬件、软件和开源生态布局,为企业在现有及新建数据中心基础设施中部署与扩展推理能力,提供更大的灵活性。

面向异构AI的开放软件
异构AI基础设施的大规模高效运行,需要开放软件来连接计算资源、简化部署流程,并让开发者灵活选择合适的架构来运行工作负载。英特尔的开放软件战略强调,将CPU和GPU支持原生集成至行业标准AI框架、推理运行时及部署环境的上游版本。依托开发者已在使用的工具,英特尔通过以下几项核心能力简化开发、优化性能并加速部署:
●简化跨英特尔GPU平台的部署:得益于统一的Xe软件底座,英特尔GPU D系列支持软件在不同英特尔GPU平台之间灵活移植,帮助开发者充分利用现有软件资产,减少在新硬件上重新部署的工作量。
●开放框架与性能优化软件:英特尔支持行业通用的AI框架、服务引擎和开发工具,并通过性能库和可编程软件层进一步提升推理吞吐量。这些框架同样支持运行在英特尔至强处理器上的推理和智能体应用,帮助开发者跨CPU和GPU架构灵活开展工作。
●对新兴开源模型的Day 0支持:通过上游框架集成和模型适配,英特尔持续推动英特尔GPU D系列和至强处理器,对最新开源模型的Day 0适配,包括对Meta Muse Glimmer模型提供Day 0支持,助力开发者更快速地评估和部署新兴的智能体AI工作负载。
●专为实际AI应用和智能体打造:英特尔软件栈支持多样化的工作负载,涵盖高吞吐词元(Token)生成、编程智能体以及复杂的企业工作流。目前,英特尔企业智能体AI工具箱(Intel AI for Enterprise Agent Toolkit)已在至强处理器上完成优化并可直接部署,为实际业务场景中的智能体应用提供编排能力。其基于不同服务提供方的可扩展架构设计可延伸至英特尔GPU,为企业的多模态工作流奠定弹性基础,也为异构计算资源的扩展提供了清晰路径。

面向异构AI的开放基础设施
英特尔通过与开放计算项目(OCP)的持续合作,推动开放基础设施的发展;自2011年以来,英特尔已向OCP贡献116项成果。
今年,英特尔展示了在Open Adapter Card(OAC)工作组中的贡献。该成果由英特尔与行业伙伴共同开发,通过定义标准化的子机柜加速卡外形规格,提升跨系统设计的机械、电气和管理互操作性,为系统构建商和云服务商将加速器集成到开放基础设施中,提供更加一致的路径。
对客户而言,这项成果的价值在于,升级AI系统不必推倒重来。企业可以在现有投入的基础上,随工作负载变化引入新的计算技术,从而更高效地扩展推理能力、管控成本,掌握基础设施升级的选择权。
智能体AI正在改变客户对数据中心的需求。未来的成功不能只靠某单一组件,更取决于将至强、专用加速与可互操作软件融为一体的开放异构基础设施。英特尔正在帮助客户在既有投入之上,持续构建灵活的基础设施,以高效扩展新兴的AI工作负载。
——Kevork Kechichian
英特尔公司执行副总裁兼数据中心
事业部总经理
向上滑动阅览
©英特尔公司,英特尔、英特尔logo及其它英特尔标识,是英特尔公司或其分支机构的商标。文中涉及的其它名称及品牌属于各自所有者资产。
相关资讯
/转载请注明出处/