北京时间 10 月 16 日凌晨,NVIDIA AI 又甩出一款本地向开源模型:Nemotron 3.5 Bolt 74B-A9B 24GB。官方原话大意是:塞进 24GB 显存就能跑的本地 Agent 模型;同日博客还写,它是为今天起出货的 RTX Spark 优化的,也适合 GeForce RTX、DGX Spark、DGX Station、RTX PRO。
Nemotron 是 NVIDIA 自家开源模型线:权重、训练数据和配方相对公开,主打高效、能长时间干活的智能体。昨晚同系列还有一款企业向的 Super VL 120B(多模态 Agent 底座);今天这篇写的是另一个 Hugging Face 包——本地 24GB 角度的 Bolt,别和 Super VL 搞混。
Hugging Face(24GB / IQ2 权重)
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB
NVIDIA 官方博客(Super VL + Bolt 同日)
https://blogs.nvidia.com/blog/nemotron-3-5-super-vl/
技术页(Bolt 专页)
https://research.nvidia.com/labs/nemotron/Nemotron-3.5-Bolt-24GB/
封面取自 NVIDIA Local AI / RTX Spark 官方博客配图(笔记本本地跑模型示意)
开了什么
按 Hugging Face 模型卡和官方博客,核心规格大致是这些:
• 开源 MoE 视觉语言模型(VLM):总参数约 74B,每个 token 激活约 9B
• 原生 2-bit(IQ2) 量化,目标塞进 24GB VRAM,还能和别的应用一起跑
• 架构:Mamba-2 + Transformer 混合 LatentMoE,外加 C-RADIO v4-H 视觉编码器
• 上下文最长约 256K token(部署时按显存可能裁短)
• 输入:文本 / 图像 / 视频;输出:文本。面向本地 Agent:调研、写代码、调试
• 同仓库生态:BF16 未量化版、GGUF、以及 LiLiCorr 投机解码草稿模型
模型卡写明:这版 24GB 包是从更大的 Nemotron 3.5 Super VL 120B-A12B压缩 + 量化 来的(Star Elastic 压缩,再对专家做 IQ2-XXS,并用量化感知蒸馏把精度捞回来)——不是另起炉灶训一个小模型。
和昨晚 Super VL 啥关系
• 同一天、同一篇博客家族,但 HF 仓库不同
• Super VL:约 120B / 12B 激活,偏企业长周期多模态 Agent,吃显存多
• Bolt 24GB:约 74B / 9B 激活 + 原生 2-bit,偏 本地 24GB 边跑边干活
• Bolt 的 BF16 父检查点也单独开了;24GB 包是量化后的本地部署版
Super VL(BF16,另文已写)
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-BF16
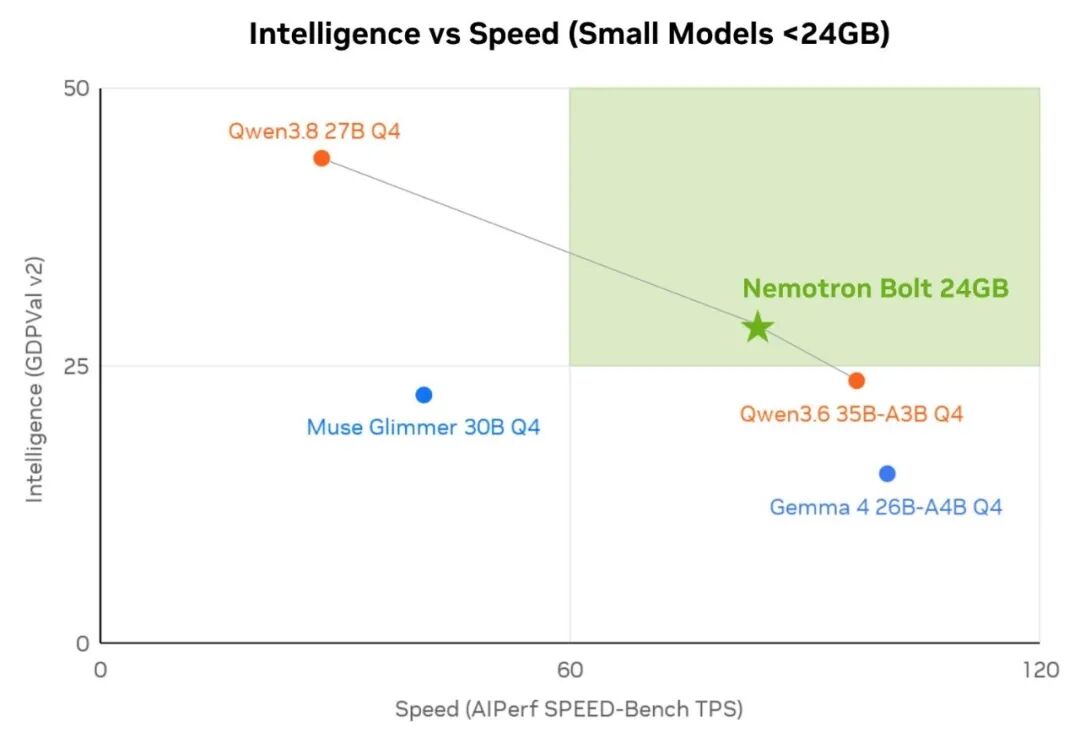
官方 Intelligence vs Speed 图(<24GB 小模型):Bolt 24GB 落在「够聪明又够快」区间(图源:@NVIDIARTXSpark / Nemotron 技术页)
RTX Spark 官方账号原话大意:74B-A9B 塞进 24GB,在智能和速度之间找平衡,边跑应用边跑 Agent;为 RTX Spark 优化,也方便你接下来的本地项目。
怎么本地跑
官方博客写明:权重已上 Hugging Face,支持 llama.cpp、Ollama、LM Studio、Unsloth、vLLM。另有一篇 RTX Spark 生态博客也写了同样的运行时名单,并提到可直接接 Hermes、OpenClaw 这类本地 Agent。
• 要 GGUF / llama.cpp 路线:看同系列 24GB-GGUF 仓库
• 要服务器侧:模型卡给了 vLLM nightly 示例(含工具调用、推理开关、视频抽帧参数)
• 硬件:博客写为 RTX Spark 优化(今天起陆续出货);也写可跑在 GeForce RTX PC、DGX Spark、DGX Station、RTX PRO 工作站
24GB GGUF
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF
BF16(未量化,方便再定制)
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-BF16
RTX Spark 本地 AI 生态博客
https://blogs.nvidia.com/blog/local-ai-rtx-spark-laptops-software-updates/
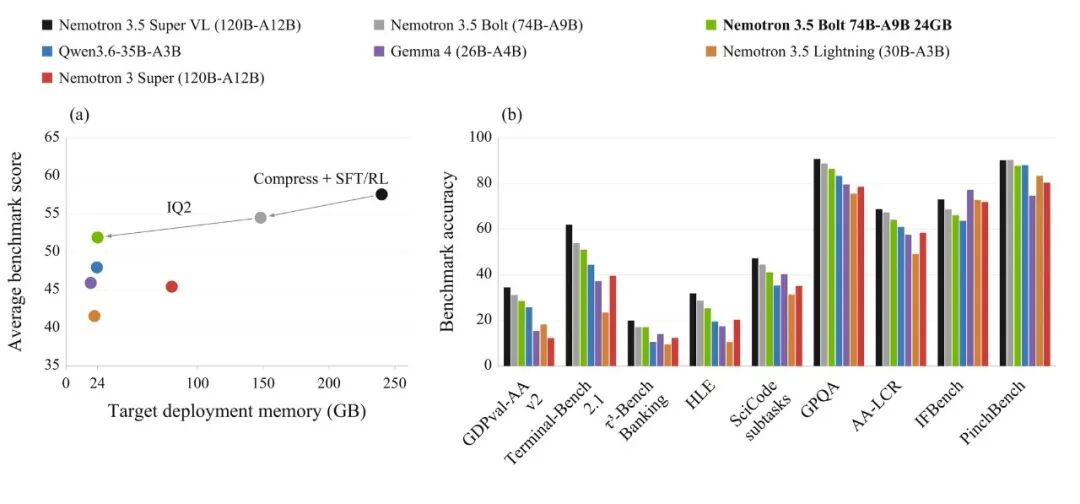
技术页附图:从 Super VL 压缩到 Bolt,再 IQ2 压到 24GB;右侧为同内存档开源对比(图源:NVIDIA Nemotron 技术页)
博客还甩了两个榜:同级开源里 PinchBench 自称第一、BrowseComp 第二。模型卡自己的表里,BrowseComp(66.75)确实明显高于同表几家;PinchBench 上 Qwen3.6-35B-A3B BF16 写的是 88.07、Bolt 是 87.82——差一丁点。「同级 / 同内存」怎么划圈,以官方设定为准;别当成全网大一统榜。
还有个更小的 Bolt E4B
同日博客顺带预告:Nemotron 3.5 Bolt E4B 4GB,更偏对话 / 实体侧 Agent,计划大约 10 月 23 日 上线。这篇主写已经开源的 74B-A9B 24GB;E4B 到了再单独说。
许可证:OpenMDW-1.1,不是 Apache
Hugging Face 标的是 other / OpenMDW-1.1,链接指向 openmdw.ai。用人话:免费用、改、再分发、商用都可以;再分发要带上协议和原有版权 / 来源声明;模型输出本身不额外加限制。不要写成 Apache 2.0,写 OpenMDW-1.1 最稳。
OpenMDW-1.1 全文
https://openmdw.ai/license/1-1/
几句提醒
• 这是量化部署包:真要继续训 / 深度定制,优先看 BF16 父权重
• 「24GB 就能跑」指官方 IQ2 打包目标;KV cache、上下文长度、并发一开,实占用会涨
• PinchBench「同级第一」是博客口径;模型卡数字和 Qwen3.6 几乎持平,别绝对化
• 和昨晚 Super VL 不是同一个 HF 包;本地 24GB 选 Bolt,企业多模态长任务看 Super VL
一句话:如果你有 RTX Spark / 24GB 级本地卡,想把调研、写代码、调试这类 Agent 留在本机,这是今天最对口的 Nemotron 开源包——先去 Hugging Face 拉 24GB 或 GGUF,再用你熟的 Ollama / LM Studio / llama.cpp / vLLM 起服务。
相关链接
NVIDIA AI 公告帖
https://x.com/NVIDIAAI/status/2110824076218605922
NVIDIA RTX Spark 公告帖
https://x.com/NVIDIARTXSpark/status/2110813633697694003
Hugging Face(24GB / IQ2)
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB
Hugging Face(GGUF)
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF
Hugging Face(BF16)
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-BF16
NVIDIA 官方博客
https://blogs.nvidia.com/blog/nemotron-3-5-super-vl/
Bolt 技术页
https://research.nvidia.com/labs/nemotron/Nemotron-3.5-Bolt-24GB/
技术报告 PDF
https://research.nvidia.com/labs/nemotron/files/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-Technical-Report.pdf
RTX Spark 本地 AI 生态博客
https://blogs.nvidia.com/blog/local-ai-rtx-spark-laptops-software-updates/
Nemotron 产品页
https://www.nvidia.com/en-us/ai-data-science/foundation-models/nemotron/
OpenMDW-1.1 许可证
https://openmdw.ai/license/1-1/
Super VL BF16(对照)
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-BF16