10月13日,爱芯元智在工博会发布AX8860系列AI芯片,6nm工艺、256 TOPS混合精度、最高128GB LPDDR5X内存、273GB/s带宽,支持64路视频解码与多芯片级联。
这套内存规格与英伟达DGX Spark、Jetson Thor处于同一水平。爱芯元智想用它把几十亿到上百亿参数的模型,从云端搬进现场。

Part 1
AX8860最突出的特点是内存和带宽。128GB LPDDR5X、273GB/s,和英伟达DGX Spark、Jetson AGX Thor处于同一档。这对工业AI具有重要意义,因为任务形态已经发生变化。
过去一台工业视觉设备,几百MB到数GB内存就能跑缺陷检测。
现在工业机器人要同时处理多路摄像头、理解语言指令、识别零件工具、生成操作计划,再调动作模型。
一个70B模型4bit量化权重就约35GB,加上量化参数、KV Cache和运行时开销,内存需求会大幅上升。
128GB内存让设备能够在本地容纳大模型和多套算法,减少从外部存储反复加载权重。
工厂不愿把生产图像持续传到云端,机器人也不能每次环境变化都等远端返回,本地计算因此减少了对网络的依赖。
大模型逐Token生成需要不断读取权重,NPU算得快,但内存供不上就会陷入等待。
用273GB/s峰值带宽粗略估算:27B稠密模型4bit权重约13.5GB,上限约20 Token/s;70B约35GB,上限约7.8 Token/s。

AX8860提供256 TOPS混合精度算力, 而DGX Spark的1 PFLOP FP4为稀疏峰值。64路视频解码是另一张牌。
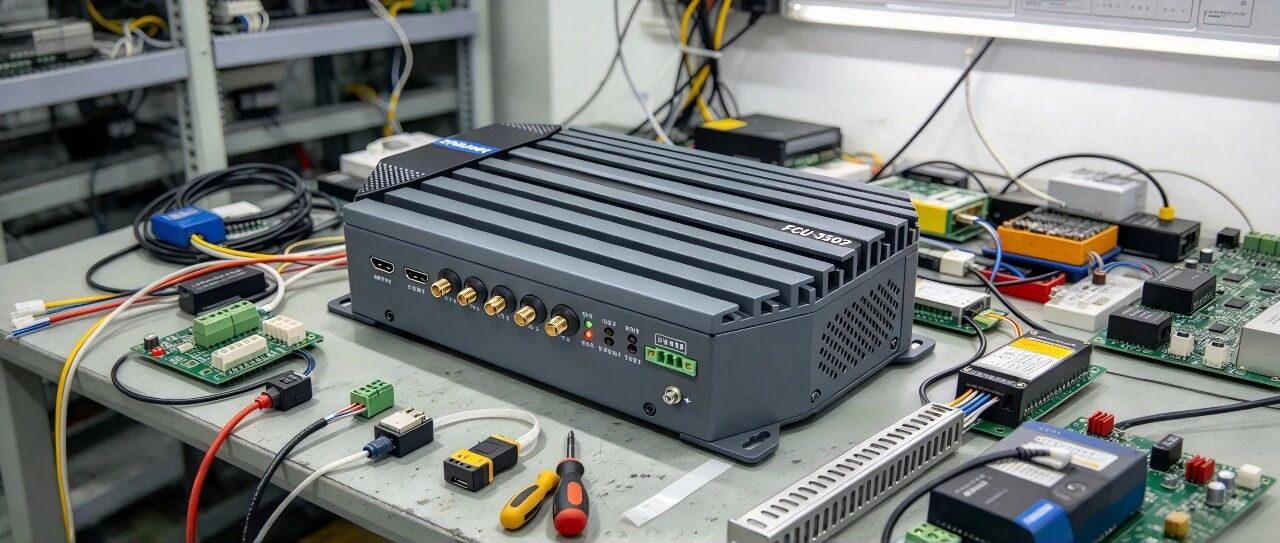
爱芯元智起家于AI-ISP和NPU,长期做视觉感知。把多路解码纳入芯片,一座工厂的数十路摄像头就无需再叠加大量工控机和独立加速卡。
Part 2
硬件底牌有了,接下来的关卡在生态和商业落地。
边缘AI市场英伟达有Jetson Orin、Thor、DGX Spark,更有CUDA、TensorRT、PyTorch、Isaac一整套。
客户如果要迁移到另一种NPU,就需要重新评估模型和软件,把PyTorch模型转成NPU计算图、补算子、做量化和编译,一旦出现不支持的算子,就可能回退到CPU执行,实测性能会远低于峰值算力。
AX8860这次强调支持vLLM、SGLang、PyTorch,兼容OpenAI API,就是想降低迁移门槛。
API兼容可以让客户专注于自己的业务逻辑,而不必关心大模型适配移植的细节。工业设备运行周期长,客户要的是能连续维护多年的软件。国产AI芯片能否进入工业大项目,最终取决于软件工程能力和长期客户支持。
AX8860支持AXLink级联和PCIe 5.0,可组成双芯512 TOPS、四芯1024 TOPS,覆盖更大模型。但多芯方案要解数据交换和模型切分问题,效率未必能达到单芯的线性倍数,需要看芯片的带宽、延迟和软件调度。
爱芯元智在发布会表示,AXLink可以高效的聚合芯片算力和内存带宽,级联效率可以达到 80%。
硬件组合丰富只是第一步,驱动、模型并行框架、故障诊断和资源调度,才是系统集成商长期采用的理由。
以工博会为起点,如果AX8860能从发布亮相走向边端侧批量部署,爱芯元智边缘计算平台提供商的定位将进一步夯实。技术门槛已经很高,软件生态和商业交付的考验则更为长期。
小结
从过去的图像采集、视频处理和目标识别,到今天的视觉语言模型、具身智能和本地大模型推理,计算平台需要处理的数据类型越来越复杂,内存容量和系统软件的重要性随之提高。