
Scaling Law作为大模型训练的黄金经验法则, 主要强调模型性能与模型参数量、数据量和计算量的正相关关系,在GPT 4、Llama 3等大模型训练中发挥了不可或缺的指引作用。
预训练阶段通过扩大模型参数量和数据量带来的模型性能提升已有所放缓,但以OpenAlo1的发布为标志, Scaling Law扩展到后训练、推理等其他阶段,算力的需求量仍将越来越大。
超节点算力并非来自单一芯片的堆叠,而是一个由计算、互联、存储、散热与软件等多层技术协同构成的系统级工程。
AI芯片作为超节点计算家族的重要组成部分,根据适用场景进行划分,主要分为AI训练芯片和AI推理芯片。
AI训练芯片主要面向模型训练阶段,承担海量数据处理、参数更新和模型优化任务。此类芯片拥有高算力、高精度、高带宽等特征,其目标是让模型从文本、 图像等多模态数据中学习规律。
AI推理芯片用于模型部署阶段 ,负责将模型应用于各类场景。此类芯片拥有低延迟、高能效比及适配云边端全场景的部署灵活性。
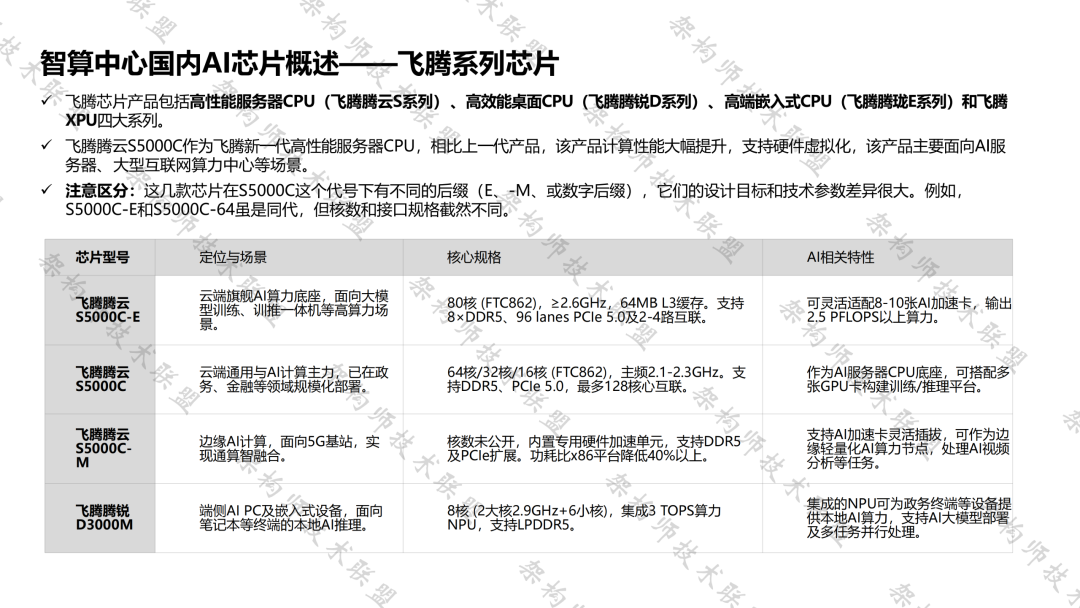
当前,国内AI芯片行业正依托“ 自主可控”战略快速崛起,形成以华为昇腾910C、 昆仑芯P800、摩尔线程MTT S5000、沐曦曦云C600等为代表的AI计算产品矩阵(AI计算产品包含AI芯片、AI计算卡等),在模型训练和推理场景中实现规模化落地。与国外追求芯片绝对算力峰值不同 ,国内更注重通过构建集群突破单点算力限制,并通过软硬件垂直整合和性价比优势抢占市场。




- -THE END- -
往期精选


FPGA技术江湖广发江湖帖
无广告纯净模式,给技术交流一片净土,从初学小白到行业精英业界大佬等,从军工领域到民用企业等,从通信、图像处理到人工智能等各个方向应有尽有,QQ微信双选,FPGA技术江湖打造最纯净最专业的技术交流学习平台。
FPGA技术江湖微信交流群

加群主微信,备注姓名+学校/公司+专业/岗位进群
FPGA技术江湖QQ交流群

备注姓名+学校/公司+专业/岗位进群




