点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
来源:3D视觉工坊
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
太长不看版:把RGB-D观测直接变换到机器人坐标系下存成"点图"(pointmap),逐元素加到RGB token上就能让VLA白捡机器人系3D几何——RoboCasa上π0.5提升7.6点、SmolVLA提升4.2点,真机上相机换到训练时没见过的位置,优势从+5.0拉大到+11.7。
标题:See like a Robot: Robot-Centric Pointmaps for Vision-Language-Action Models
作者:Byungkun Lee, Dongyoon Hwang, Dongjin Kim, Hojoon Lee, Minho Park, Jaegul Choo
机构:KAIST AI; Holiday Robotics
论文:https://arxiv.org/abs/2607.11498
主页:https://davian-robotics.github.io/pointmap/

导读
视觉-语言-动作(VLA)模型根据视觉观测和语言指令来预测机器人动作。但有个一直被忽视的"暗坑":这些动作是在机器人自己的3D坐标系里定义的,而绝大多数VLA却是在相机坐标系里观察场景的——观测所在坐标系和动作所在坐标系对不上,产生了"坐标系错配"。
在固定相机视角下,这个错配无伤大雅,策略网络背也能背下来单一的"观测到动作"映射;但如今的大规模数据集动不动就把各家机构、各种相机位姿的演示数据揉在一起,策略必须把这种映射泛化到不同视角上,错配就变得越来越棘手。
本文用"机器人中心点图"(robot-centric pointmap)来解决这个错配:这是一张每个像素都存着对应场景点在机器人坐标系下3D坐标的图。点图既提供了机器人坐标系下的3D几何,又保留了预训练2D VLA所期待的稠密H×W网格结构,因此几乎不用改架构就能插进现有VLA。
在RoboCasa上,点图同时提升了π0.5和SmolVLA,并超过了代表性的相机视角类与3D感知类基线。真机实验里,当相机被挪到训练时没见过的位置时,它相对纯RGB策略的优势反而进一步拉大。换句话话说:视角越变,它越香。

▲ 机器人中心点图提供与机器人坐标系动作对齐的3D几何。大规模训练数据采集自机器人周围五花八门的相机视角。机器人中心点图在保留预训练2D VLA所期望的稠密H×W网格的同时,提供了以机器人为中心的3D几何(对比深度图和点云的 trade-off:深度图绑死在相机系,点云丢掉2D网格且变稀疏)。
效果展示
训练时相机视角扰动越大,纯RGB策略掉得越惨,而RGB+Pointmap几乎纹丝不动:视角扰动从"无"加到"高",RGB成功率暴跌9.6个点(34.5%→24.9%),而RGB+Pointmap只掉1.8个点(37.6%→35.8%)。

▲ 训练时相机视角变化的影响。随着视角变化增大,RGB性能持续下滑,而RGB+Pointmap保持稳定。
引言
视觉-语言-动作(VLA)模型从大规模数据集中学习机器人操作策略,根据视觉观测和语言指令预测动作。这些动作通常定义在机器人自己的3D坐标系中(例如机器人基座坐标系下的任务空间末端执行器指令),因此可靠的操作需要推理目标物体相对于机器人处于米制3D坐标中的什么位置。然而,大多数VLA接收的观测是在相机坐标系下的——无论是RGB图像还是深度图。这就产生了一个坐标系错配:策略在相机坐标系中观测场景,却在机器人坐标系中预测动作。
当训练数据涵盖多样的相机视角时,这个坐标系错配会变得更难处理——如今的大规模数据集越来越多地把来自不同机构、不同相机设置的演示聚合在一起。在固定相机视角下,所有观测相对于机器人共享同一个视角,因此单一的观测到动作映射在整个数据集中保持一致。而在广泛变化的视角下,这一点不再成立:策略必须额外学习来自不同视角的观测应该如何映射到它们应产生的机器人坐标系动作。坐标系错配在两种情况下都存在,但只有在视角变化的情况下,策略才必须将观测到动作的映射泛化到不同视角,而不是死记单一映射。
这促使我们重新审视策略的输入观测:与其让策略从相机坐标系的观测中推断机器人坐标系的动作,不如直接提供已经携带以下两种信息的观测——(1)用于操作的3D空间信息,(2)且该信息就在机器人自己的坐标系中。如图1所示,深度图虽能提供3D线索,但仍绑定在相机坐标系而非机器人坐标系上。点云可以提供机器人中心的3D几何,但它丢弃了预训练2D VLA所使用的规则H×W图像网格,难以无缝集成;它还把稠密观测缩减为稀疏的3D点集,可能丢失对操作有用的细粒度细节。这些权衡表明,我们需要一种既能提供机器人坐标系3D几何、又能保留RGB观测图像形态结构的输入。
在本文中,我们用机器人中心点图作为预训练VLA的输入来实现这一思路。机器人中心点图是一张图像,其像素存储着对应场景点在机器人坐标系中的3D坐标。图2展示了相机坐标系的观测如何被表达到机器人坐标系中。我们先将每个RGB-D观测在其相机坐标系内升维到3D,然后将其变换到动作所定义的共享机器人坐标系中,同时保留RGB图像的H×W布局。这使得点图只需极小的架构改动即可集成到现有2D VLA中。我们用一个从RGB编码器初始化的独立视觉塔来编码点图,然后将得到的点图token逐元素加到对应的RGB token上。它不需要点云专用编码器或体素化模块;而且由于点图token是加到RGB token上而非拼接,因此不会引入任何额外token。
主要贡献
本工作的核心贡献是一种简洁的机制:无需点云专用编码器,就能将机器人坐标系3D几何注入预训练VLA;同时我们对点图输入背后的设计选择及其对性能的影响进行了受控分析。在RoboCasa上(其训练演示包含随机化的相机视角),我们的方法将π0.5和SmolVLA分别提升了+7.6和+4.2个点,并优于代表性的相机视角类与3D感知类基线。在使用Franka机器人的真机实验中(演示数据采集自多个相机视角),相对RGB基线的增益从训练相机位姿下的+5.0个点,扩大到训练时未见过的留出相机位姿下的+11.7个点。
方法
方法的核心思路非常"直白":既然动作定义在机器人坐标系,那就别难为策略自己去猜坐标变换了——在策略学习之前,先把每个RGB-D观测升格为机器人中心点图。具体来说,对每个像素先做相机系反投影,再应用相机到机器人的外参变换,把点表达到机器人基座坐标系中;进一步地,作者还把点图重新中心化到当前末端执行器位置(end-effector-centered pointmap),让观测和动作空间共享同一个原点——毕竟动作本来就是末端执行器的运动。

▲ 来自不同相机坐标系的观测,被表达到机器人动作所定义的坐标系中。
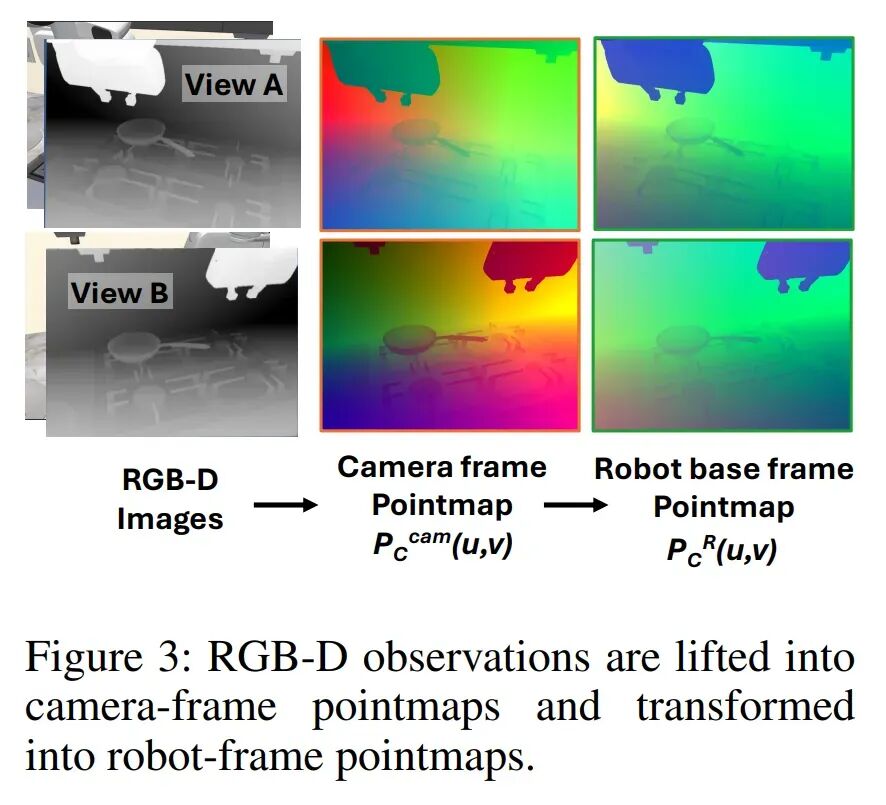
▲ RGB-D观测先被升格为相机坐标系点图,再被变换为机器人坐标系点图。
融合方式也极尽"克制":因为点图保留了与RGB图像相同的H×W网格,作者直接用与VLA的RGB编码器同架构的独立点图编码器(从RGB编码器初始化)来编码它,然后把点图token逐元素加到对应的RGB token上。没有点云编码器、没有体素模块、没有新增token序列,机器人中心3D几何就这样"丝滑"地混进了VLA原有的视觉通路。

▲ 模型架构。每个RGB-D相机观测被转换为以末端执行器为中心的机器人中心点图。RGB和点图输入分别由独立的SigLIP视觉塔编码,点图token逐元素加到对应的RGB token上后进入预训练VLA。VLA从融合后的视觉token、语言指令和本体感觉中预测动作块。
实验结果
作者先在RoboCasa上做了一组受控研究(保持骨干和训练配方不变,只改3D几何的提供方式),回答四个问题:给相机信息够不够?点图还是点云?坐标原点选哪?视角变化增大时还稳不稳?
相机信息 vs. 预计算机器人系几何:给策略Plücker射线(逐像素编码相机内外参)略有提升(27.9→28.7),再加深度升到31.6,但直接把机器人系点图预计算好喂进去达到34.7——后两者用的深度和标定信息完全相同,唯一区别就是机器人系几何是否预先算好,这3.1个点的差距干净地隔离出了"预计算"的收益。

▲ 直接提供机器人中心3D几何 vs. 让策略自己学。D/K/E分别表示是否向模型提供深度、内参和外参。最后两行使用相同的深度与标定信息,区别仅在于机器人坐标系几何是否被预计算。
图像形态点图 vs. 点云:同样的机器人系3D点,用点云+MLP编码只有24.2,换Point Transformer v3也只有32.8,而点图+逐元素相加达到34.7。关键就在于点图保留了RGB像素网格,能和RGB token做空间对应的逐元素融合,而点云的特征与RGB token没有空间对应关系,只能拼接。

▲ 图像形态 vs. 点云。所有变体都向RGB基线加入相同的机器人坐标系3D点,区别仅在于点的编码与融合方式。SR表示成功率。

▲ 点图-RGB融合方式。逐元素相加(add)保留了空间对应关系,而拼接(concat)把点图token当作独立序列处理。
末端执行器中心化:坐标原点的选择影响巨大。以机器人基座为原点时,"在水槽边抓"和"在微波炉边抓"这两个本质相同的动作,目标点的基座系坐标却毫无关联;以末端执行器为原点后,抓取时刻目标坐标都坍缩到原点附近,共享相同动作模式的交互获得了一致的局部几何。固定视角下成功率从34.7升到36.9;评估视角随机化时,基座中心点图掉2.0个点,末端执行器中心点图只掉0.3个点。

▲ 末端执行器中心化将交互目标聚集到共同原点附近。(a) 目标坐标在机器人基座系中分布分散,但在末端执行器中心坐标系中聚集在原点附近。(b) 两个示例任务表明:机器人基座系坐标迥异的目标,在抓取时刻都落在末端执行器中心原点附近。
主实验(RoboCasa,24个任务):π0.5的24任务平均成功率从55.3升至62.9,五个任务类别全线提升;SmolVLA从37.2升至41.4。最强的相机感知基线KYC(59.1)和最强的3D增强基线PointVLA(57.3)都在加了点图的π0.5(62.9)之下。唯一不共享π0.5骨干的FP3只有42.8——它不继承2D VLA的大规模视觉语言预训练,稀疏点云输入(每视角约4k点)也可能不太适合需要精确放置的任务。

▲ RoboCasa结果(成功率%,固定视角),覆盖五个类别的24个任务。除FP3(独立点云策略)外所有方法均使用π0.5骨干。阴影行为加入本文点图的结果。
真机实验:Franka Research 3配两个RealSense相机(腕部D405固定,外部D435i摆在3个训练位姿+1个留出测试位姿),4个任务、共180条演示。相机在训练位姿(Seen)时,点图把π0.5从73.3提升到78.3(+5.0);相机换到留出位姿(Unseen)时,纯RGB的π0.5从73.3跌到55.0,而加点图的π0.5稳在66.7——点图只退化11.6个点,RGB却退化18.3个点,领先优势从+5.0拉大到+11.7。DP3从反方向印证了同一结论:3D输入天生比RGB更抗视角漂移。

▲ 真机实验设置。(a) Franka Research 3配一个固定腕部相机和一个外部相机,外部相机放置于三个训练位置(红)和一个留出测试位置(蓝)。(b) 任务:抓取放置、叠方块、开/关抽屉。

▲ 真机相机泛化结果。所有模型在四个操作任务上、于见过和未见的相机配置下各评估15次(成功率,%)。
这些结果指向一个更普适的优势:点图在训练数据横跨多相机视角时尤其有用——每个场景点被赋予固定的机器人系坐标,相机怎么挪它都不变;而纯RGB策略必须自己学每个视角到机器人系动作的映射,视角覆盖越广越难拟合。这与4.4节的仿真趋势一致,也解释了真机上留出位姿处优势为何扩大。
总结 & 未来工作
我们研究了当演示数据采集自各种相机视角时,VLA应如何使用3D观测。在这种设定下,同一个任务在训练期间可能从不同相机视角被观测到,这要求策略将图像观测与机器人的动作坐标系关联起来。我们没有把这种相机到机器人的关系留给策略从RGB、深度和标定输入中自行推断,而是将每个观测到的场景点直接以机器人中心点图的形式表达在机器人坐标系中。点图保留了稠密的H×W图像网格,使机器人中心3D坐标能够通过预训练VLA现有的视觉通路与RGB token融合。
我们的实验指向一个简单而有效的输入:以末端执行器为中心的、图像形态的机器人坐标系点图。机器人中心点图在仿真和真机实验中都提升了预训练VLA。这些结果提示了3D感知VLA的一条通用原则:当标定可用时,先把观测表达到机器人行动所在的坐标系中,再交给策略。机器人中心点图在践行这一原则的同时,保留了预训练VLA已经在使用的图像形态结构。
局限性:我们的研究仍留下若干未决问题。我们没有消融点图相对于动作专家的注入方式,也没有考察它与预训练配方的相互作用,因此两者的最佳组合方式仍未确定。与点云的对比只使用了单一的采样预算,更大的预算可能会缩小我们报告的差距。此外,点图在训练和测试时都需要已标定的相机内外参,这将其限制在可获取标定的设置中。最后,我们的相机变化结果聚焦于相机位置和外参的变化,尚未涵盖相机数量或视场角的变化,我们将其留作未来工作。
对更多实验结果和文章细节感兴趣的读者,可以阅读一下论文原文~
本文仅做学术分享,如有侵权,请联系删文。
。


扫码添加微信,备注:姓名+方向+单位,邀请入群。