点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
0. 论文信息
标题:Any3R: Feedforward 3D Reconstruction from Any Camera Type
作者:Jingong Chen¹˒², Qingwen Zhang³†, Youming Deng⁴†, Chulwoo Pack¹, Olaf Wysocki⁵, Boris Jutzi⁶, Kwanghee Won¹*, Kyle Gao²(†共同贡献,*通讯作者)
机构:¹南达科他州立大学(South Dakota State University)、²阿尔托大学(Aalto University)、³瑞典皇家理工学院(KTH Royal Institute of Technology)、⁴康奈尔大学(Cornell University)、⁵剑桥大学(University of Cambridge)、⁶卡尔斯鲁厄理工学院(Karlsruhe Institute of Technology)
原文链接:https://arxiv.org/abs/2610.36150
代码链接:https://github.com/Jingong-Chen/Any3R
项目主页(可在线交互查看3D结果):https://jingong-chen.github.io/Any3R/
模型权重:https://huggingface.co/Jingong/Any3R
1. 导读
VGGT、π³、MapAnything 这一类“几何基础模型”,输入一组照片,一次前向就能输出相机位姿和稠密点云,已经成为三维重建的新范式。但它们有一个默认前提:输入是针孔相机拍的照片。
现实中的相机远不止针孔。机器人和自动驾驶大量使用超过 180° 的鱼眼,VR 和街景采集用 360° 全景,安防摄像头、运动相机、手机超广角镜头各有各的畸变。网上的众包照片和历史档案影像,更是各种镜头混在一起。
现有做法的问题:
先去畸变再用针孔模型: 视场超过 180° 的鱼眼根本没法校正成一张针孔图,强行裁剪就丢掉了大片视野。 为每种镜头单独训练一个模型: 成本高,也处理不了“同一个场景里混着好几种相机”的情况。
Any3R 的核心观察是: 对于所有“中心相机”(所有光线都经过同一个光心,绝大多数真实相机都是),镜头的全部信息其实就是每个像素的光线朝哪个方向,也就是“射线场”。不管是针孔、鱼眼还是全景,只要把射线场交给网络,网络就不需要知道镜头类型、畸变系数或视场角上限。
进一步,作者发现针孔假设其实“藏”在主干网络的两个地方:
位置编码: 旋转位置编码(RoPE)用图像的行号和列号给每个图块定位。这在针孔图上大致等于“这个图块朝哪看”,但在鱼眼和全景上,同一个行列号指向完全不同的方向。 训练损失: 每个像素在损失里权重相同。但在不同镜头上,一个像素覆盖的视野大小(立体角)差别很大,比如全景图两极的像素就很“窄”。
Any3R 把射线场同时交给这两处,于是一套权重服务所有中心相机:不用去畸变,不用按镜头重新训练,同一个场景里可以任意混合多种相机。

2. 效果展示
同一条街,20 张视图分别用 8 种相机拍摄(从 90° 针孔一直到 360° 全景),Any3R 一次前向,用自己预测的相机位姿把它们拼成一个完整的场景:

真实的超 180° 鱼眼:消费级双鱼眼相机的一个镜头(约 214°),使用数据集自带的 COLMAP 标定。这类镜头 Any3R 训练时从没见过:

单一相机的多视图:200° Kannala–Brandt 鱼眼沿街拍摄 12 张,以及 8 张 360° 全景,都来自训练时没有用过的测试街区:


以上结果都可以在项目主页上拖动、旋转、缩放查看。主页上还能逐个回放“相机一台台加入、点云逐步长出”的过程,并在同一视图下切换对比各个方法。
3. 主要贡献
一个前馈模型,适用于任意中心相机的任意组合。 不需要搜索标定、不需要去畸变、不需要针对镜头重新训练。每个视图都可以来自不同的相机,视图数量也不限。 两个模块:“角度坐标”和“立体角加权”。 它们把主干网络中依赖像素网格的位置编码和训练损失,改为由稠密射线场决定,从而让一套权重服务所有中心相机。 新的跨相机基准和全面的实验。 在三个公开数据集上,把同一组视图分别用 13 种中心相机成像,所有方法都用各自预测的位姿进行重建。Any3R 在重建精度和位姿精度上都取得最好的结果,在广角和全景镜头上优势最大。
4. 方法

4.1 用“射线场”描述相机
对于中心相机,每个像素都对应一条从光心出发的光线。Any3R 把这张“每个像素的光线方向图”作为相机的唯一描述输入网络,再配一张掩码,标出鱼眼圆外这类没有光线的像素。
网络对每个像素只预测一个量:沿这条光线的距离 d,三维点就是 X = d × 光线方向。这样,同一个解码器对所有相机都适用,包括与光轴夹角超过 90° 的光线。射线场可以由任何标定计算出来(COLMAP、OpenCV、鱼眼模型,或者只知道“这是一个 190° 等距鱼眼”),开源代码里内置了 13 种常见的相机模型。

4.2 角度坐标:用“图块朝哪看”代替“图块在第几行第几列”
主干网络(VGGT-Omega)用旋转位置编码(RoPE)告诉注意力每个图块的位置,原本用的是行列号。Any3R 改为:先把每个图块内像素的光线求平均,得到这个图块的平均光线,算出它的仰角和方位角,再把这两个角度作为 RoPE 的坐标。
这样做的好处:
一个坐标单位在所有相机上代表同样的角度。 混合批次里不同相机的视图共享同一套频率,含义一致。 在全景图上与原始编码完全一致。 作者推导出的系数保证在等距柱状投影(全景)网格上,角度坐标逐项还原原来的行列号坐标,所以预训练学到的编码不会被破坏。 逐视图计算。 每个视图用自己的射线场编码,而不是全部套用第一个视图的镜头。
发布的模型还做了“分频段”处理:低频部分用绝对角度,保证跨相机一致;高频部分除以该视图自身的视场范围,铺满每个相机自己的视野。
此外,主干网络在每个注意力块之前还会给每个图块加一个绝对位置嵌入,Any3R 同样改为用该图块平均光线的角度来计算,让每个 token 的绝对位置也跟着光线走。
4.3 立体角加权:按“看到了多少世界”给像素加权
不同镜头上,一个像素覆盖的视野大小不同。如果每个像素权重相同,像素密集的区域就会主导训练。Any3R 在点损失里给每个像素乘上它在单位球面上覆盖的立体角,相当于在球面上而不是在各个镜头的像素网格上积分。立体角直接由射线场求导得到,不需要相机模型,也不需要额外输入。
4.4 训练
初始化: 从 VGGT-Omega 微调,在 32 张 GH200 上训练 40 个 epoch,约 27 小时。 训练数据: Matterport3D、Stanford2D3DS、Structured3D、PanoCity 和 DL3DV 视频,测试场景全部留出。 相机采样: 全景训练样本中,一半是原生全景;另一半把全景重采样成随机相机的视图,相机从 8 种模型中均匀抽取(针孔、Brown–Conrady、等距、Kannala–Brandt、MEI、双球、全景、裁剪全景),视场角 30°–360°。每个视图独立抽相机,所以一个样本里经常同时出现窄视场针孔、宽鱼眼和完整全景。
5. 实验结果
基准设置: 在 Matterport3D、Stanford2D3DS(室内)和 PanoCity(室外)上,每个数据集 24 个测试场景,每个场景 3 张视图。同一组视图分别用 13 种中心相机成像,其中 8 种用于训练,5 种训练时没见过,所以不同相机之间的差别只来自镜头本身。
评测口径: 所有方法都用自己预测的相机位姿把视图融合成点云,再用一个相似变换对齐到真值后评测。
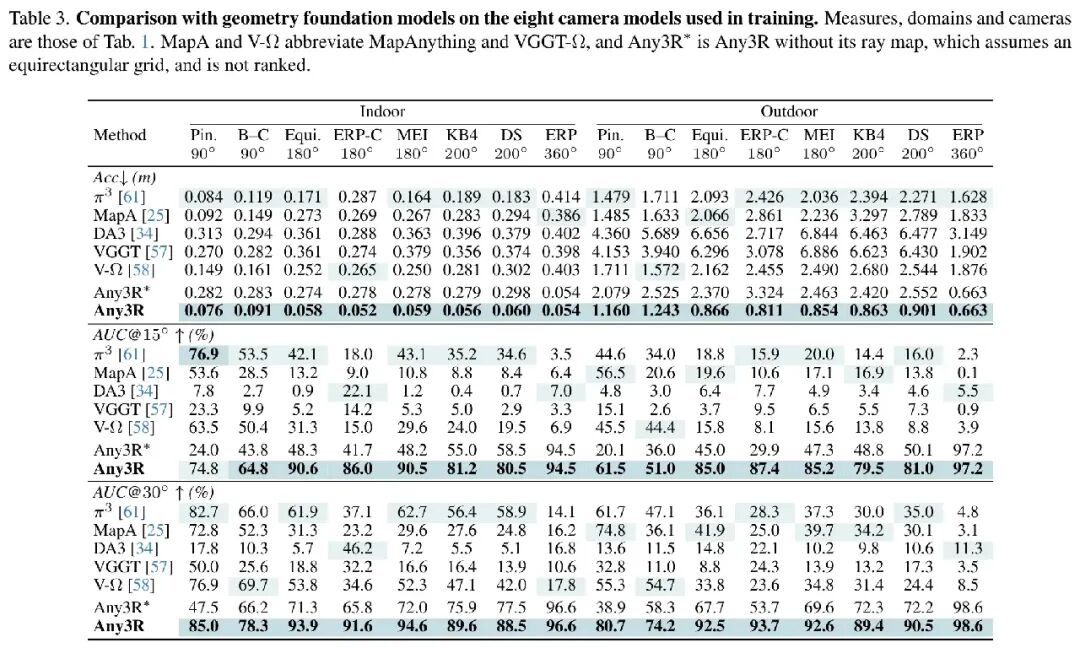
Acc: 重建点到真值点的平均距离,越低越好; AUC@15° / AUC@30°: 两两视图之间位姿误差曲线下的面积,越高越好。
5.1 与面向其他相机的方法对比
对比方法包括 OmniVGGT、Wid3R、PanoVGGT、Argus,以及把真实射线场直接输入 MapAnything 射线编码器的 MapA-ray。其中 Wid3R 和 MapA-ray 也拿到了真实射线场。“–”表示该方法无法处理这种相机。在 8 种相机、室内外两种设置下,Any3R 的 Acc、AUC@15、AUC@30 全部第一:


5.2 与几何基础模型对比
对比 π³、MapAnything、Depth Anything 3、VGGT 和 VGGT-Omega。Any3R* 是不输入射线场的 Any3R(此时默认把输入当作全景),不参与排名。
结果:
Any3R 在全部 16 列中的 Acc 都是第一,AUC@30 也全部第一; AUC@15 只有室内针孔一项是第二,第一是 π³; 针孔视场之外,现有几何基础模型的精度明显下降,而 Any3R 在 180°–360° 的镜头上依然稳定。
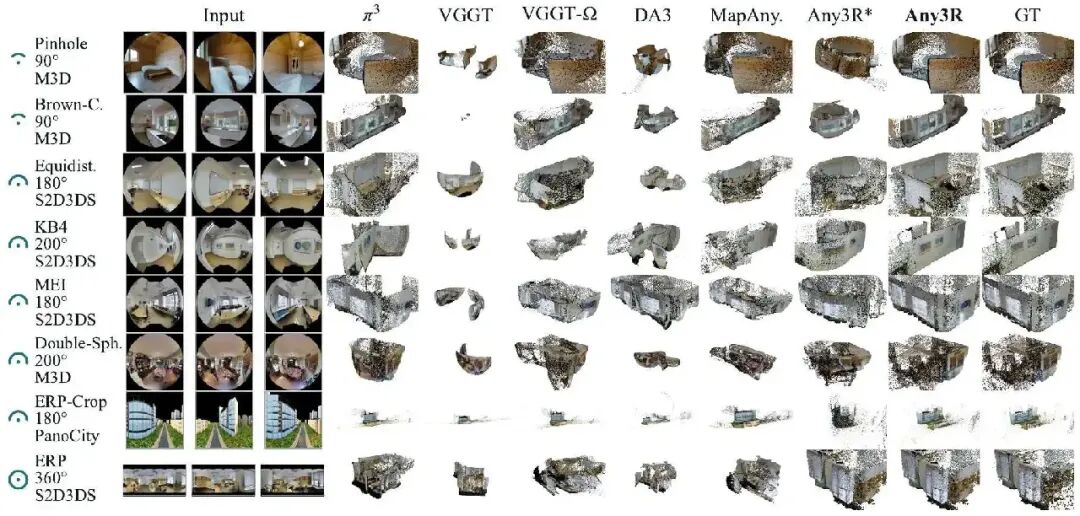
下图来自项目主页的交互对比:同一个 200° KB4 鱼眼场景,左边是 Any3R,右边是 MapA-ray。两个窗口共享同一个视角,灰掉的按钮表示该方法无法处理这种镜头:

5.3 射线场到底起了什么作用
把同一个网络的射线场“拿掉”(此时它会把每张图都当成全景来读),结果如下图所示。以 90° 针孔为例:
拿掉射线场时: 图像被拉伸铺满整个球面,重建塌成一团; 给了射线场后: 图像只占球面上属于它的那一小块,重建出完整的房间。
只有在 360° 全景上两者才一致,因为那正是“当作全景来读”恰好正确的情况。

5.4 真实鱼眼镜头上的零样本测试
上面的相机都是从全景渲染出来的。为了检验真实镜头,作者又在两个训练中完全没用过的真实鱼眼数据集上测试:
ScanNet++ 的单反鱼眼(约 146°): Any3R 排第二,第一是 Wid3R,而 Wid3R 正是在 ScanNet++ 上训练的; FIORD 的超 180° 鱼眼: Any3R 三项指标全部第一,并且领先明显。


5.5 速度与显存
模型约 11.5 亿参数,推理用 bfloat16。在单张 RTX 5090 上:
32 张 512×512 视图约 1.1 秒; 128 张约 9 秒,显存峰值 17.7 GB。
6. 总结
总结: 几何基础模型的针孔假设,藏在位置编码和训练目标里。Any3R 用稠密射线场同时改造这两处(角度坐标 + 立体角加权),得到一个统一的前馈模型:针孔、畸变镜头、超 180° 鱼眼、360° 全景都能用同一套权重处理,并且可以在同一个场景里任意组合,不需要搜索标定、去畸变或针对镜头重新训练。在 13 种中心相机、3 个数据集组成的基准上,所有方法都用自己预测的位姿重建,Any3R 是精度最稳定领先的方法。这使得直接用各种来源、各种镜头混杂的影像(手机、鱼眼监控、全景设备、众包与历史档案照片)做规模化的三维重建成为可能。
开源情况: 项目已开源推理代码、13 种相机模型(支持 COLMAP、OpenCV 标定读入)、模型权重、命令行与 Gradio 交互 demo,以及复现论文基准的评测代码。据项目说明,在论文的运行环境下,评测结果可以与论文数字逐场景对齐。感兴趣的读者可以直接下载试用。
代码:https://github.com/Jingong-Chen/Any3R
项目主页:https://jingong-chen.github.io/Any3R/
论文:https://arxiv.org/abs/2610.36150
本文仅做学术分享,如有侵权,请联系删文。
。


扫码添加微信,备注:姓名+方向+单位,邀请入群。