
工业流水线上的分拣设备、家庭场景中的服务机器人,要让机器人灵活应对复杂的真实场景,可靠的通用操控能力是核心前提。
过去这类机器人操控智能体大多依赖闭源前沿大模型,虽然零样本泛化表现亮眼,但权重不公开的特性让研究者很难针对机器人场景做进一步训练优化,API 调用的高成本与推理速度瓶颈也限制了大规模落地。
最近来自清华大学、UC 伯克利等机构的研究团队推出了统一的机器人智能体框架 uni-robot-agent,打破了闭源模型的垄断,让开源模型也能获得媲美前沿闭源模型的机器人操控能力,为机器人智能体的普惠化研究提供了基础支撑。

论文标题:Democratizing Robot-Use Agents: A Unified Harness with Open Models
论文链接:https://arxiv.org/pdf/2611.01560v1
研究背景
随着通用大模型能力的提升,基于大模型的机器人操控智能体逐渐展现出不错的零样本操控能力,这类智能体可以复用大模型内置的任务拆解、故障恢复等通用问题解决能力,突破了传统机器人算法依赖有限场景数据的限制。
但此前这类方案大多依赖 GPT-6 Astra、Claude Opus 5.5 等闭源前沿模型,研究者只能调用 API 测试效果,无法针对机器人场景做模型层面的微调优化,API 调用的高成本也让大规模交互训练难以开展。(GPT-6 Astra 的表现:)
此前针对开源模型的机器人适配方案,大多需要依赖仿真环境提供的真值深度、任务成功反馈等特权信息,或者接入任务特定的技能库,这类方案很难迁移到没有特权信息的真实场景中。
研究团队认为,在将开源模型的能力不足作为前提做针对性优化之前,首先需要构建一个通用、高效的机器人操控框架,系统性地释放开源模型已经具备的能力,为后续的训练优化打下基础,uni-robot-agent 正是基于这个目标设计的。
框架核心设计
uni-robot-agent 是一个模块化、可扩展的通用机器人智能体框架,连接不同的智能体运行时与仿真、真实机器人的共享工具集,智能体根据任务指令和观测选择操作,框架负责执行操作并返回标准化的反馈,整体设计遵循统一、高效、真实、模块化四大原则。

框架整体分为五层逻辑架构,从上层到下层分别是智能体层、编排层、工具层、服务层和后端层,各层之间有明确的接口,研究者可以独立替换智能体运行时、工具、感知模型和机器人后端,适配不同的研究需求。

统一交互接口是框架的核心特性之一,框架为智能体提供了标准化的运动、感知、技能、任务控制工具集,不管是仿真环境还是真实机器人,同类操作的参数、单位、反馈格式完全一致,仅需要为新环境开发对应适配器即可,不需要为每个环境单独重写工具逻辑,既降低了适配成本,也让跨环境收集的交互数据可以直接合并用于后续训练。

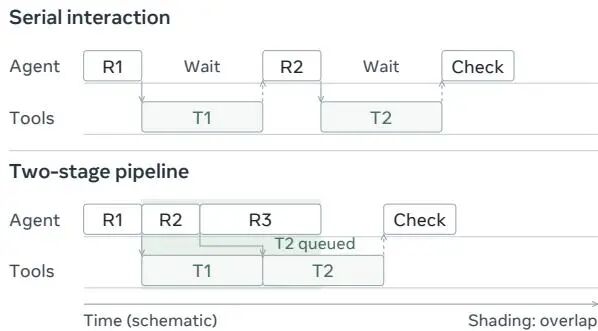
为了提升执行效率,框架设计了流水线执行机制,支持模型推理与工具执行并行,不需要等每一个动作执行完成再开展下一步推理。对于共享同一资源的操作会按提交顺序执行,独立操作可以并行处理,在 5 个典型任务的测试中,流水线执行相比串行执行耗时降低了 4.8% 到 73.7%,物理执行时间的 84.5% 到 93.8% 都可以和模型推理重叠,大幅缩短了整体任务耗时。
为了保证仿真训练的效果可以迁移到真实场景,框架在设计时就明确不依赖仿真环境的特权输入,仅使用真实部署场景中可获取的 RGB 图像、相机校准参数、机器人本体状态和任务指令,不需要仿真提供的真值深度、物体 CAD 模型、隐藏场景标注、任务校验反馈等信息,确保了方案的可落地性。
除此之外,框架还在观测与状态一致性、通信失败防重复操作、运动与夹爪控制协同、执行进度自动监测、可诊断反馈返回、上下文滑动窗口管理等细节做了优化,进一步提升了机器人交互的可靠性。
实测性能表现
研究团队分别在仿真环境和真实机器人场景中对框架的性能做了测试,验证了开源模型基于该框架可以获得媲美闭源模型的操控能力。
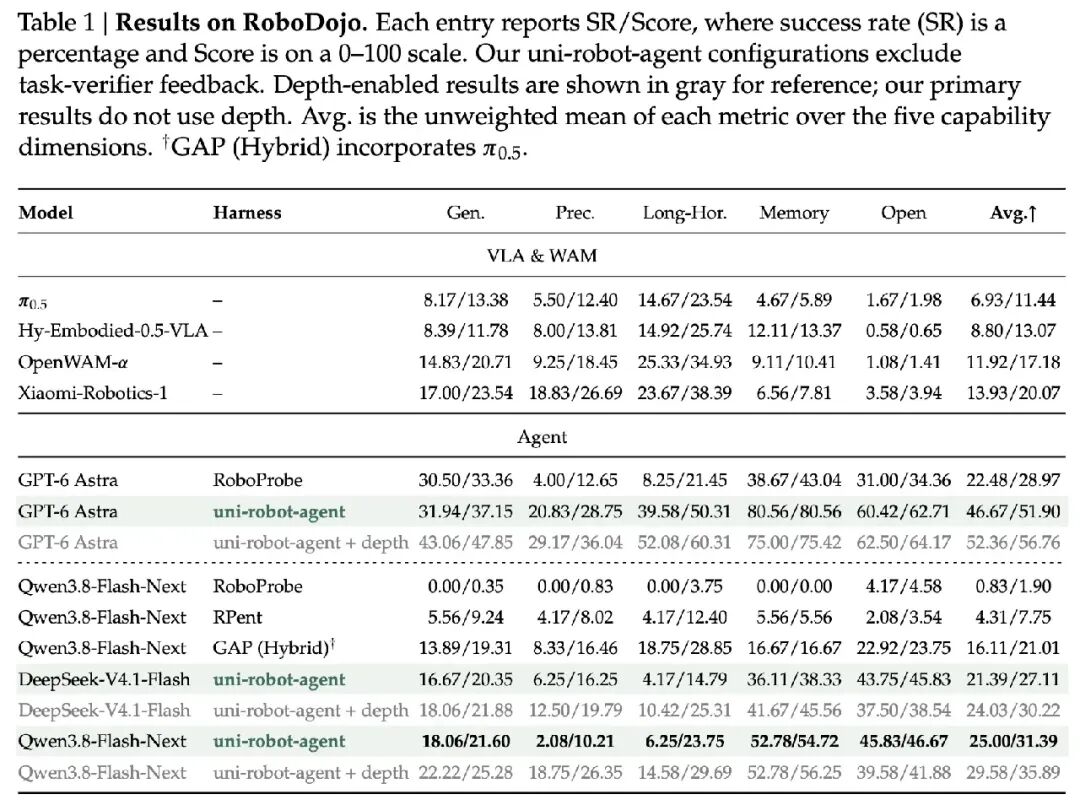
仿真测试采用 RoboDojo 基准,涵盖 42 个任务,分布在泛化性、精度、长时序执行、记忆、开放词汇指令跟随五个维度,测试过程不使用任何特权输入。
测试结果显示,搭载 uni-robot-agent 的 Qwen3.8-Flash-Next 取得了 31.39 的总分,超过了搭载 RoboProbe 框架的 GPT-6 Astra 的 28.97 分,同时也超过了榜单上所有 VLA 和 WAM 基线模型。
搭载该框架的 DeepSeek-V4.1-Flash 也取得了 27.11 的总分,超过了大部分基线模型。
作为对比,Qwen3.8-Flash-Next 切换到其他框架时性能会出现大幅下降,最多下降超过 10 分,充分验证了框架对性能提升的作用。
真实场景测试采用团队自研的 19 项桌面操控任务基准,覆盖空间理解、物体泛化、指令跟随、组合泛化、未见过的任务五个维度。
测试结果显示,搭载 uni-robot-agent 的 Qwen3.8-Flash-Next 取得了 49.50 的总分,和经过每个任务 10 小时演示数据微调的 π0.5 模型持平,超过了零样本测试的 Dream-1 模型的 35.50 分,证明了框架可以适配真实机器人场景的需求。

机器人操控能力的核心要素
为了进一步探究机器人操控能力的来源,研究团队对比了不同代际、不同家族、不同参数量的模型的表现,发现机器人操控能力并不是最新一代模型独有的,更早的 GPT-5.6 Sol 已经可以取得 24.04 的得分。
而不同模型家族的能力演进路径差异很大,Qwen 系列只有到 3.8 代才展现出有效的机器人操控能力,更早的版本哪怕参数量更大也没有相关能力。
这说明模型参数量的影响远不如训练分布的影响,针对性的训练数据对机器人操控能力的提升作用更加明显。
通过对失败轨迹的分析,研究团队总结出四大常见失败模式,分别是通用视觉理解错误、空间定位错误、几何编码错误、具身推理错误,这四类错误的发生率和模型的任务得分呈明显负相关,说明有效的机器人操控能力是这四类通用能力的组合,而不是某一项机器人专属的能力。
进一步的测试显示,模型在这四个维度的能力和通用大模型基准测试的得分呈正相关,说明通用能力的提升可以直接转化为机器人操控能力的提升,未来的机器人智能体训练可以针对性地优化这四类能力,而不需要只关注动作输出的拟合。
额外分析:特权信息、成本与效率
针对行业关心的特权信息依赖、落地成本、执行效率等问题,研究团队也做了针对性的分析。
在特权信息方面,测试显示深度信息并不是机器人操控的必要条件,只要提供相机参数,模型可以通过多视图三角计算自行推导 3D 坐标,去掉深度输入后,GPT-6 Astra 的得分仅下降 1.4%,Qwen3.8-Flash-Next 的得分也仅下降 12.5%,只有同时去掉相机参数时,性能才会出现大幅下降。
另外框架的性能也不依赖任务特定的技能库,禁用技能库后,Qwen3.8-Flash-Next 的得分仅下降 3.4%,几乎没有明显影响。
在成本方面,开源模型的性价比优势非常明显,Qwen3.8-Flash-Next 完成单任务的平均成本仅为 1.09 美元,而 GPT-6 Astra 虽然得分更高,但是单任务平均成本达到 21.29 美元,是前者的近 20 倍,开源模型的低成本优势非常适合大规模交互训练和落地部署。
在执行效率方面,流水线设计的提升效果非常明显,测试显示物理执行过程中 84.5% 到 93.8% 的时间都可以和模型推理重叠,不需要等待动作执行完成再开展推理,大幅降低了整体任务耗时。
总结与展望
uni-robot-agent 为机器人操控智能体的研究提供了一个统一、高效、可扩展的基础框架,首次实现了开源模型在 RoboDojo 基准上超过闭源前沿模型的表现,降低了机器人智能体的研究门槛,让更多研究者可以在开源模型的基础上开展相关训练和优化工作。
目前该方案在精细操控、长时序执行的可靠性方面还有提升空间,未来研究团队会基于该框架进一步收集跨环境的机器人交互数据,探索针对机器人场景的模型训练方法,进一步提升开源机器人智能体的能力,推动通用机器人技术的落地。
> 本文由 AI 生成,机智流编辑部校对
-- 完 --
机智流推荐阅读:
1.
2.
3.
4.
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群



