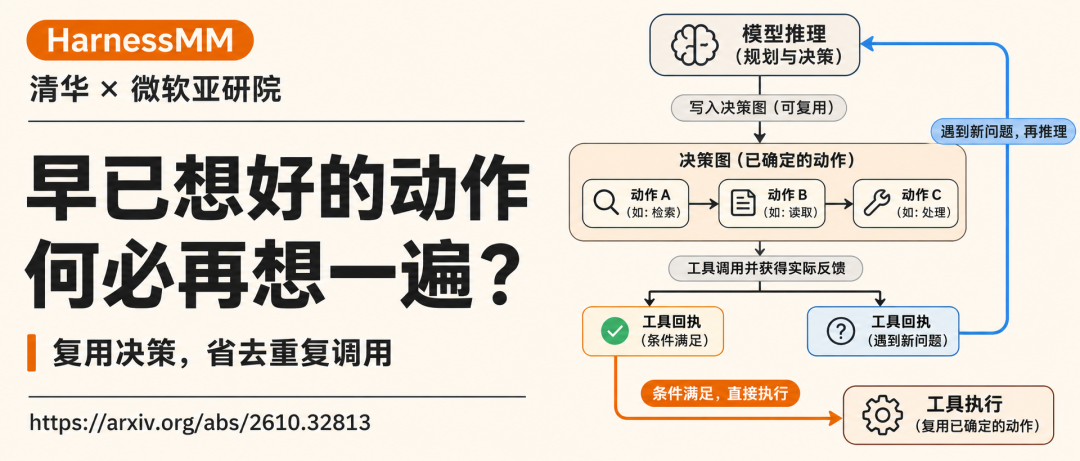
编程智能体写好代码,下一步编译,编译成功后运行测试。这几个动作,有时在第一次推理中就已经确定了。后续工具返回的结果,只是在告诉系统:现在能否执行下一步。
但常见运行流程仍然是“工具返回—调用模型—再决定动作”。每次都重新输入上下文、重新生成判断,可能把已经做过的决策又做了一遍。
清华大学与微软亚洲研究院的 HarnessMM,研究的就是这种重复计算。它让智能体把已经确定的后续动作保存下来,等真实工具反馈满足条件后,直接执行;遇到新的语义问题,再回到原模型推理。
在论文自定义划分的 98 道 HumanEval 测试题上,集成 HarnessMM 后,Codex 运行框架的成功率保持 90.82%,每题输入加输出 token 从 6.672 万降至 4.702 万,减少 29.54%。这个结果背后的关键问题是:怎样证明一条“快速路径”真正替代了原来的模型调用?

论文:HarnessMM: Recursive Self-Improvement for Harness Token Efficiency
作者:Yuhua Jiang、Chang Xu、Feifei Gao、Li Zhao
单位:清华大学;微软亚洲研究院(Microsoft Research Asia)
论文链接:https://arxiv.org/abs/2610.32813v1
背景:快速路径也可能增加总开销
Harness 可以理解为智能体的运行框架:它负责组织提示词和上下文、调用模型、执行工具、处理反馈与恢复失败。模型权重不变,运行框架的不同,也会影响完成任务的质量与成本。
减少 token 的常见办法,包括压缩上下文、限制推理长度,或者让较轻的决策过程处理简单步骤。HarnessMM 关注另一个位置:某次模型调用是否还有必要发生。
作者将一个容易忽略的成本问题称为“替代悖论”。系统增加了一个快速选择器,看起来每次只输出很少内容,但若后面仍然调用原模型来生成同一个动作,总开销反而变成原有调用加上选择器费用。
真正的节省,要求被移除的计算大于新增的动作编写、选择、上下文和失败恢复开销。因此,快速路径的触发次数、单次输出长度,都不足以独立证明系统更省。需要同时核对实际少了哪些请求,以及整个任务最终用了多少 token。
方法:把“做什么”与“现在能不能做”分开
HarnessMM 的基础表示叫可执行决策图(Executable Decision Graph,EDG)。模型在一次推理中,除了输出当前动作,还可以写出一组已经确定的未来动作。
每个节点包含动作、完整的字面参数、前序依赖,以及基于公开工具反馈的执行条件。例如,编译命令和测试命令已经写好,测试节点的条件是“对应编译动作已完成,且返回码为零”。
这里的关键是,后续反馈只改变节点是否具备执行资格,不重新生成命令或修改参数。如果测试命令还要根据尚未读到的文件内容临时构造,它就没有满足这种复用要求,需要再次调用模型。
在这张图之上,带条件的决策复用(Guarded Decision Reuse,GDR)负责跨工具步骤保留节点。每次工具返回后,系统检查前序是否完成、条件是否为真,以及参数是否已经完整确定。符合条件的唯一节点可以确定性执行;存在多个候选时,受约束的选择器只返回候选编号或放弃,不得改写动作。
工具报错、依赖缺失、反馈无法解析、条件不成立或选择器放弃,都会把控制权交回原推理模型。新一轮推理也可以继续写出新的决策图,所以复用可以在任务中多次发生。
核验:执行了旧动作,还要证明少了一次调用
带有核验记录的回调替代(Certified Callback Substitution,CCS)将满足条件的节点送到原有工具接口执行,同时跳过原本注册在这个位置的推理调用。
系统为这次替代保存记录,包括决策图的内容指纹、节点编号、前序工具反馈、实际参数、执行结果,以及被跳过的调用标识。审计据此检查:执行的是原先写好的动作,中间也没有再插入一次慢推理请求。
这种记录证明的是执行过程与调用省略。动作本身是否正确,仍取决于此前模型判断、执行条件是否充分,以及最后的任务评分。即使记录完全有效,也可能执行了一个写错的计划。
成本同样在完整任务上统计,包含图的编写、选择器输入输出、剩余推理、失败调用、回退与收尾。缓存输入仍计入 token。记录一次被省略的调用,并不意味着可以为它凭空估算一个“节省 token 数”;净收益来自两组完整运行的实际用量比较。
实验:完整配置省了多少,机制本身贡献多少
论文分别比较 Codex、DeepSeek Harness 与各自集成 HarnessMM 的版本。同组比较保持后端模型、任务、工具和评分器一致。这里的两个名称指运行框架;研究干预发生在框架层,模型权重保持固定。
HumanEval 的 164 道题被划为 33 道训练、33 道验证和 98 道测试。训练用于修改候选配置,验证负责选择,最终配置在测试前冻结。每道测试题执行一次,失败任务也纳入成本分母。
DeepSeek Harness 这一对的 token 减少 87.93%,成功率提高 14.28 个百分点。按题配对,出现 22 道由失败转成功、8 道由成功转失败;Codex 则各有 5 道改善和退步,总成功数相同。
这两组测量针对集成后的完整配置,其中还包含上下文处理和收尾规则等改变。尤其是 token 节省主要体现在输入侧:DeepSeek Harness 的每题输入从 92.45 千降至 7.09 千,输出则从 3.83 千升至 4.53 千。87.93% 的总降幅不能全部归于局部决策复用。
机制记录提供了另一种证据:DeepSeek Harness 的付费模型请求总数从 954 次降至 415 次,其中有 147 次经过核验的局部替代。总请求差与核验次数测量的是不同对象,前者还受到整个执行路径变化的影响。

消融:持续保留决策图确实有价值,也存在质量取舍
为了更直接地检验核心机制,作者在相同的 257 道 MBPP-sanitized 测试题上,固定提示词、图编写格式、上下文、工具与运行限制,仅改变决策图的使用方式。

相对一次性图,持续复用减少了 26.91% 的完整任务成本;相对保留推理调用,成本减少 19.52%。完整方法记录了 407 次核验替代,其中 201 张图被复用了两次。
但节省与质量仍需一起看。相对禁用图执行,完整方法少用了 18.62% 的 token,同时少解出四道题。作者报告的多重比较调整区间中,只有相对一次性图的成本节省区间排除了零;其他两项成本区间和三项正确率差异区间都包含零。这些单次执行结果支持继续研究,并未消除运行波动的不确定性。
递归改进:更新运行配置,训练曲线有自己的范围
论文标题中的递归自我改进,发生在运行框架配置层。当前配置执行训练任务,产生质量与 token 反馈;据此开发候选修改,验证后保留配置,再为下一轮提供反馈。它不更新执行模型的权重,测试阶段也不继续根据测试结果修改配置。
MiniWoB++ 展示了训练反馈指导下的八次配置迭代,调整涉及视觉定位、截图上下文等内容。在同一批 32 个训练任务上,第 1 次到第 8 次迭代,HarnessMM 成功率从 34.38% 升至 90.63%,每题 token 从 3.26 千降至 1.06 千。
这个变化属于训练任务上的配置开发曲线。它包含配套组件的改动,不等于模型能力在独立测试集上持续自我增长。第 8 次迭代的同轮对照更具体:两组都解决 29 道题,持续复用比一次性图少用 29.83% 的 token。
局限:任务是否有可复用决策,决定了节省空间
收益并未出现在所有场景。AIME 的完整 560 题比较中,HarnessMM 准确率为 87.14%,接近无额外技能配置的 86.96%;但计入共享编写成本后,每题 token 从 4.59 千增加到 5.90 千。该任务主要消耗在生成推理上,减少的输出不足以覆盖新增输入和编写费用。
跨任务结果还涉及不同干预。ALFWorld 的主对比检验指令内容,SearchQA 涉及路由、草稿与回退,不能统一解释成决策图复用的收益。运行框架是否适合复用,需要看后续动作能否提前确定、公开反馈能否可靠判断条件,以及回退成本有多高。
开发阶段的候选搜索、验证和被拒绝尝试,与部署任务执行成本分开核算。要判断总体是否划算,还需把开发投入摊到实际部署任务量中。token 减少也不直接等于延迟、能耗或账单同比下降,论文没有为这些指标提供同等范围的验证。
HarnessMM 的具体贡献,是把已完成的决策变成后续可执行、可检查的对象。它让工具反馈承担一个更精确的角色:在足够明确的条件下,激活已有动作;遇到尚未解决的问题,再请求模型推理。这样的分工能否带来收益,最终由完整任务的质量和实际成本共同回答。
> 本文由 AI 生成,机智流编辑部校对
-- 完 --
机智流推荐阅读:
1.
2.
3.
4.
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群