*口径:功耗、距离等数字为厂商与分析机构公开口径的区间,非实测;时间点为公开路线图,非本报告预测
*本文是科普与分析,不构成投资建议。
零、
四个名词描述的是同一件事的四种做法:把电信号变成光信号的那个“光引擎”,放在离交换芯片多远的地方。可插拔放在前面板、插上就能用;XPO 还是可插拔,只是做得更大更热要液冷;NPO 把光引擎搬到芯片旁边的插座上,激光器留在面板;CPO 把光引擎和芯片焊在同一块封装基板上。越靠近芯片,电走线越短、越不需要 DSP、越省电,代价是越难维修、生态越封闭、制造越难。
速率数字只是“通道数 × 单通道速率”:1.6T 可插拔是 8 条 200G;3.2T 可插拔想用 8 条 400G(器件未熟)或 16 条 200G(封装更大);3.2T NPO 是 16 条 200G;6.4T NPO 是 32 条 200G;12.8T 是 64 条 200G。所以“6.4T NPO”并不比“1.6T 可插拔”更先进,它只是把 4 个 1.6T 的光引擎放到了芯片旁边。
还有一个常见误解要先澄清:今天量产的 CPO 封在一起的都是交换芯片,不是 GPU。把算力芯片和硅光封在一起也叫 CPO,业内常另称“光 I/O”,那是 2028 年前后的事(第 4.4 节)。NPO 因为是板级方案,光引擎既可以放在交换芯片旁,也可以放在加速卡上 XPU 旁。

<点击图片可放大查看>
若您对硅光SiGe技术及流片相关话题有更多探讨需求,欢迎添加微信深入交流。

一、
1.1 速率是怎么算出来的
光模块的“T”永远是电通道数 × 单通道速率。现在一代的单通道是 200G(PAM4 调制,波特率约 106 GBaud,电口按 224G 计含开销),一个 OSFP 封装能放 8 条电通道,所以 1.6T = 8 × 200G。要到 3.2T,要么每条通道翻到 400G(器件还没熟),要么把通道数翻到 16 条(封装要更大,叫 OSFP-XD)。NPO 与 CPO 的“光引擎”同样按这个算:3.2T = 16 × 200G,6.4T = 32 × 200G,12.8T = 64 × 200G。到了交换机整机一级,一台 102.4T 的交换机可以是 64 个 1.6T 可插拔,也可以是 8 个 12.8T XPO,也可以是 16 个 6.4T NPO 或 CPO 光引擎。

图 1 名字里的 T 是怎么算出来的:色块 = 电通道,颜色 = 单通道速率。3.2T 可插拔的两条路(8×400G 或 16×200G)与 3.2T NPO(16×200G)在这张图上一目了然。
DR8 / DR4 / FR4 / LR4:D、F、L 是距离(500m / 2km / 10km),后面的数字是光通道数。1.6T DR8 是 8 条 200G 光;1.6T DR4 是 4 条 400G 光(电口仍是 8×200G,靠 DSP 做 8:4),光纤少一半,是通往 3.2T 的“先导品”。
OSFP / QSFP-DD / OSFP-XD:可插拔的封装外形。OSFP 是 1.6T 的主流(8 条电通道),OSFP-XD 有 16 条电通道,是 3.2T“加道”路线的载体。
200G/lane、400G/lane:单通道速率,是整个行业的代际分界。200G/lane 对应 1.6T 一代(2026 量产),400G/lane 对应 3.2T 一代(2027–28),IEEE 802.3 今年 3 月才成立 400G/lane 研究组,OIF 的 CEI-448G 电口框架已发布。
1.2 四种形态一图看懂

图 2 同一块交换机主板上四种形态的位置。蓝线 = 电走线,橙线 = 光纤。可插拔与 XPO 在面板,NPO 在芯片旁的插座上,CPO 在芯片的封装基板上;NPO/CPO 的激光器都以 ELSFP 形式放在面板。
读这张图只需要记住一件事:电信号在铜线上跑得越远,衰减越大,就越需要模块里的 DSP 把信号“重整”一遍,DSP 是可插拔模块里最耗电的芯片(1.6T 模块 20–25W 里 DSP 占大头)。NPO 把电走线从 20–30 cm 缩到 2–5 cm,CPO 缩到毫米级,于是都可以去掉 DSP,用“线性直驱”——这就是它们省电的根本原因。至于把激光器单独拿出来做成面板上的 ELSFP,是因为激光器是最容易坏、最怕热的器件,放在面板上既好散热又能热插拔。
二、
2.1 模块里面有什么,FRO / LRO / LPO 是什么
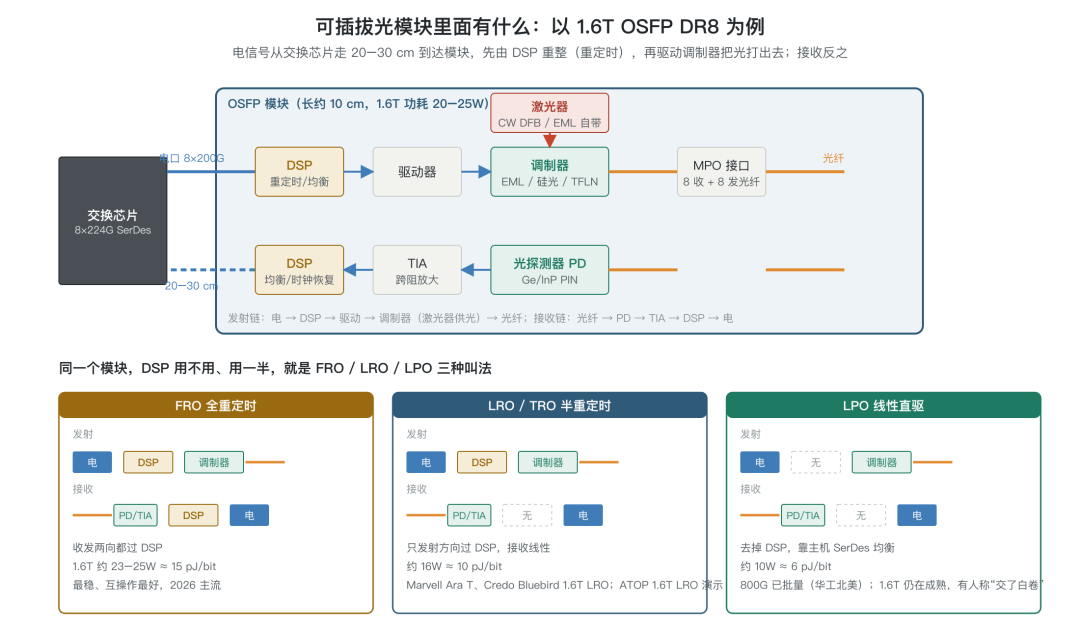
图 3 1.6T OSFP DR8 内部:发射链电 → DSP → 驱动 → 调制器(激光器供光)→ 光纤;接收链光纤 → PD → TIA → DSP → 电。下方三个小图是同一个模块的三种 DSP 用法。
FRO 全重定时:收发两向都过 DSP,1.6T 约 23–25W(第二代 3nm DSP 方案 25W),折算约 15 pJ/bit。最稳、互操作最好,是 2026 年的主流。
LRO/TRO 半重定时:只有发射方向过 DSP,接收方向线性,约 16W、10 pJ/bit。Marvell 的 Ara T(8×200G TRO,功耗降 35%)、Credo 的 Bluebird 1.6T LRO 都是这一类;光博会上 ATOP 展 1.6T OSFP224 DR8 LRO 实时误码演示(2027Q1 交付)。
LPO 线性直驱:去掉 DSP,完全靠交换芯片的 SerDes 做均衡,约 10W、6 pJ/bit。800G LPO 已经批量(华工向北美头部客户批量交付),1.6T LPO 还在成熟中,OCP APAC 上有厂商直言“LPO 在 1.6T 交了白卷”,Counterpoint 则称英伟达 Vera Rubin 的网卡端会用 LPO。
调制器三选一:EML(电吸收调制激光器,InP 材料,Lumentum/博通/Coherent 主供)、硅光 MZM 或微环(CW 激光器 + 硅光芯片,成本低、缺 EML 时的“泄压阀”)、TFLN(薄膜铌酸锂,带宽最高但 1.6T 窗口被硅光拿走,主战场推到 3.2T)。中际旭创 1.6T 与 800G 的硅光占比已过半。
2.2 1.6T 现在的状态
量产与缺口:OFC 2026 上多家确认 1.6T 从送样转入量产;中际旭创半年报口径 2026 年全球需求约 2500 万只、有效产能约 1500 万只;Coherent 口径需求从 2025 年 180 万只增至 2026 年 3000 万只以上,英伟达占六成以上。各家出货预测在 1000 万到 3000 万只之间,差异主要来自 200G EML 供给假设。
价格与功耗:1.6T EML 方案 1000 美元以上、硅光约 900 美元,中际旭创硅光目标 800 美元;功耗 20–25W。800G 已跌破 400 美元。
形态:OSFP 是 2026–27 的安全假设;英伟达平台上同时存在三种 1.6T(全重定时 EML、LRO、硅光微环 COUPE)。
2.3 3.2T 的三条路:升速、加道、做大

图 4 可插拔从 1.6T 到 3.2T 的三条路径:路径 A 升速(8×400G,封装不变,等器件)、路径 B 加道(16×200G,用 OSFP-XD 大封装,等不及 400G/lane 的客户)、路径 C 做大(12.8T XPO,8 个 1.6T 引擎合体,液冷)。
路径 A(升速)是正统:需要 400G/lane 的电口与光口。DSP 有博通 Taurus BCM83640(3nm,已送样、2026 底量产);光侧三条路都在 OFC 演示过:博通/Coherent/Lumentum 的 400G EML、Coherent 的硅光 400G/lane 链路、索尔思与 HyperLight 的 TFLN;光博会上光迅做单波 400G 实链路 Live Demo,华工做 3.2T 实时演示(450Gbps PAM4、TDECQ 小于 2.5dB、3nm/2nm DSP)。行业共识仍是 2027 末至 2028 年商用。中国移动牵头的 400G per Lane MSA 将在 9 月 10 日发布规范 Draft 1.0。
路径 B(加道)是权宜:OSFP-XD 有 16 条电通道,器件全部沿用 1.6T 一代,缺点是光纤数翻倍、面板密度到顶。
路径 C(做大)是可插拔阵营对 CPO 的反攻:XPO 把 8 个 1.6T 光引擎合成一个 12.8T 模块,64 条电通道、单模块 400W、冷板液冷、保留热插拔,1RU 能做到 204.8T;Arista 牵头的 XPO MSA 有 100 余家加入,新易盛、光迅、华工是创始成员,华为参与,路线图延到 25.6T(400G/lane 电口)。它解决的是“前面板密度到顶”,不解决“电走线太长要 DSP”的问题,功耗上仍是可插拔那一档。
三、
3.1 结构:光引擎搬到芯片旁边,激光器留在面板

图 5 NPO 交换机主板俯视示意:交换芯片居中,6.4T 光引擎(32×200G 硅光)装在芯片周围的 Socket 插座上,电走线 2–5 cm、线性直驱无 DSP;ELSFP 外置激光器与 MPO/MMC 光纤口在前面板,橙线为光纤。
NPO 的英文是 Near-Package Optics,“近封装”的意思是光引擎不在交换芯片的封装里,而是在封装旁边的主板上。它和 CPO 共享大部分器件(硅光 PIC、线性驱动 EIC、外置激光器 ELSFP、光纤阵列 FAU),差别只在光引擎是焊在芯片基板上还是插在主板 Socket 上。这个差别决定了三件事:可不可以换(Socket 可以换)、要不要改交换芯片封装(不用改)、生态谁说了算(主板和引擎可以来自不同厂商)。还有第四件事:NPO 的光引擎不一定绕交换芯片,也可以放在加速卡上 XPU 旁边——超节点 Scale-up 场景里两种位置都可能出现,这一点 CPO 今天做不到(见 4.4)。

<点击图片可放大查看>
3.2 为什么中国云厂选 NPO
阿里的原话:“Scale-Up 网络 NPO 先行、CPO 长期演进”——Scale-out 网络继续用 8 通道 OSFP 可插拔(代际兼容、开放解耦、即插即用),Scale-up 的 GPU 直连短距用“线性直驱 + NPO/CPO”,其中 NPO 在 224G/lane 以内性能足够、易规模化落地,CPO 是最优性能与最高带宽密度的长期方向。
信通院转述的行业态度:“大型云厂商对封闭自研的 CPO 方案持保留态度”,NPO“兼具技术可行性、量产能力与可靠性”。腾讯 2026 年一季度已完成 NPO 样品验证,9 月 9 日海思论坛上腾讯姜志滨讲“NPO 光互连超节点规模部署前景与挑战”。
供应链原因:CPO 依赖台积电 COUPE 与 CoWoS 一类先进封装,这条链集中在台湾且与 AI 芯片抢产能;NPO 用 2.5D Flip-Chip 与主板 Socket,国内封装厂、光模块厂、连接器厂都能参与,光迅/华工/新易盛已经能出货引擎。
可维护性原因:万卡集群里光引擎坏一个是常态,NPO 换引擎、换 ELSFP 都不用动交换芯片;CPO 要换整个封装。中国联通胡雅坤把 CPO 的“可靠性、可维护性以及封闭生态”列为当前关注重点,把 NPO 定位为“CPO 规模应用前的折中方案,已启动标准化”。
标准原因:OIF 12.8T NPO 项目由中国机构主导提交,阿里在光博会上讲“NPX 规格与 NPO 标准化”,华为讲 NPO 光引擎,博通也来讲 VCSEL NPO——这是国内云厂第一次在光互连形态上掌握定义权。
3.3 NPO 的软肋
仍有 2–5 cm 电走线,到 400G/lane 一代(XSR/VSR 短距电口)是否还能线性直驱,是 3.2T NPO 之后的关键问题。
板上布局与散热复杂:16 个引擎绕着一颗 1000W 级的交换芯片,加上光纤 Shuffle(光迅专门做了 FMU-Shuffle 光纤管理单元)。
外置光源本身是新的供应瓶颈:ELSFP 需要 25dBm/400mW 级高功率窄线宽激光器,Lumentum 拿到首个 ELS 订单要 2027 下半年才交付;阿里同时提出“NPO/CPO 应支持激光器内置(液冷已解决散热)”,与外置光源路线有张力。
标准刚起步:OIF 12.8T 5 月才立项,光迅与华工的 6.4T 引擎接口是否互换、Socket 与连接器形态(TE、安费诺、YAMAICHI 三家在光博会上讲)能否统一,决定 NPO 是不是真“开放”。
若您对硅光SiGe技术及流片相关话题有更多探讨需求,欢迎添加微信深入交流。

四、
4.1 结构:光引擎和交换芯片在同一块基板上
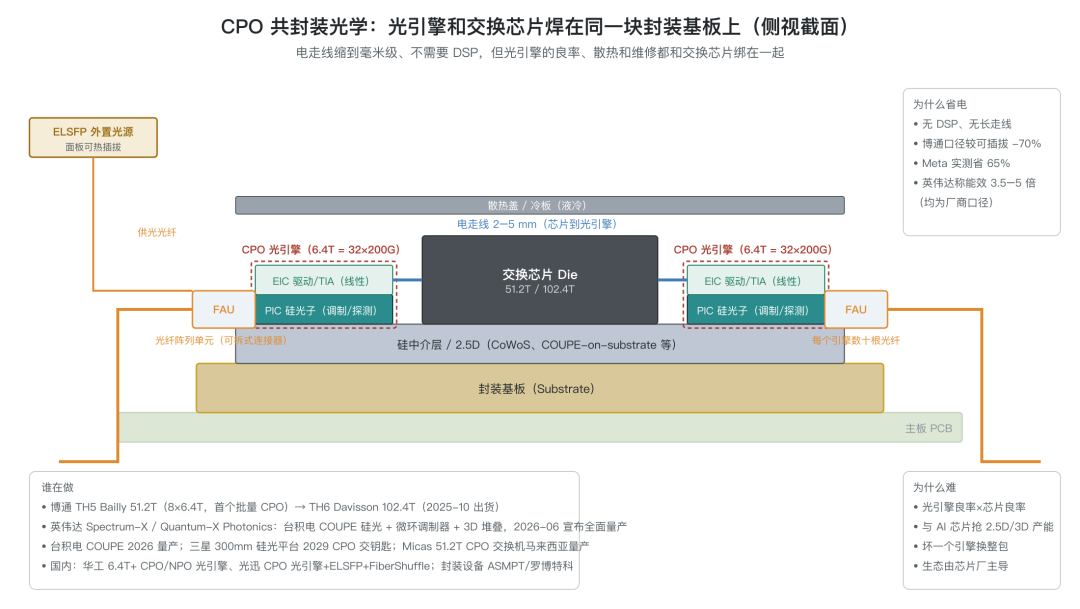
图 6 CPO 封装侧视截面:交换芯片 Die 与光引擎(EIC 驱动/TIA + PIC 硅光子)并排放在硅中介层与封装基板上,电走线毫米级;光纤经 FAU 光纤阵列引出,激光由面板 ELSFP 经光纤送入。
CPO 的英文是 Co-Packaged Optics。它把光引擎从主板搬进了交换芯片的封装里:电走线只剩 2–5 mm,连驱动都可以做得很简单;博通的口径是功耗较可插拔降 70%,Meta 实测省 65%,英伟达称能效 3.5–5 倍。代价是光引擎良率乘以芯片良率才是整包良率,散热与芯片绑在一起,坏一个引擎要换整个封装,而且封装工艺(台积电 COUPE、CoWoS、3D 堆叠)与 AI 芯片抢同一批产能。
4.2 谁在做,量产到哪一步
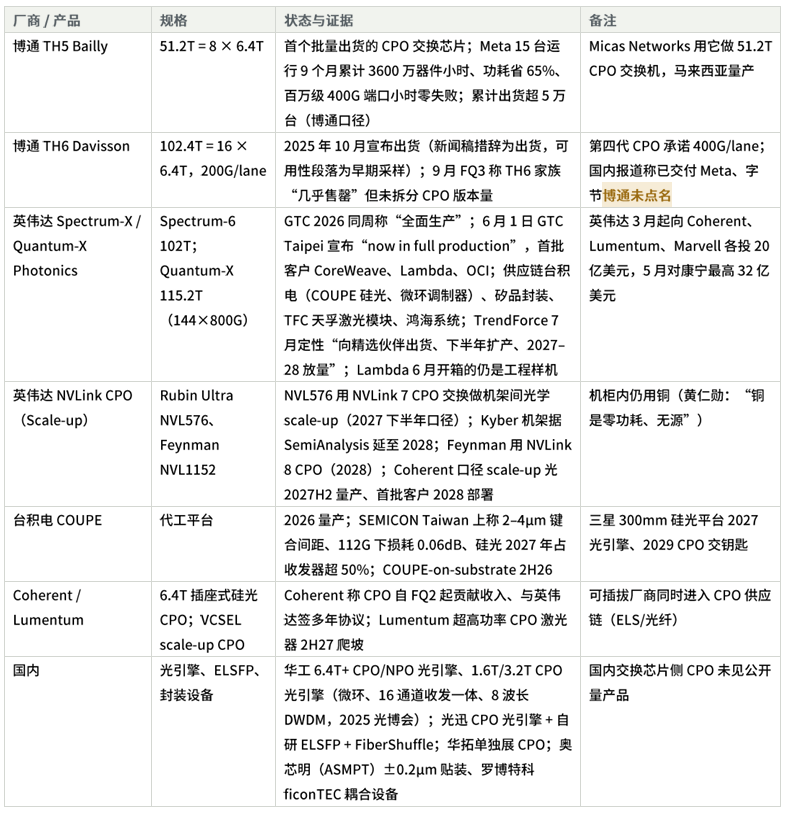
<点击图片可放大查看>
4.3 为什么难
良率:一颗 102.4T 交换芯片本来就贵,再加 16 个光引擎,任何一个引擎的问题都拖累整包;英伟达论文里微环调制器的制造变异是公开讨论的话题。
产能:光引擎的 2.5D/3D 封装与 AI 芯片的 CoWoS 抢产能,TrendForce 把“光引擎良率与先进封装产能”列为 Spectrum-X CPO 放量的两大瓶颈。
维修与运维:坏一个引擎换整个封装;可拆式光连接器(FAU)是缓解手段但不是根治。
生态:CPO 的定义权在芯片厂(博通、英伟达),光模块厂变成光引擎与 ELSFP 供应商;这正是中国云厂对“封闭自研 CPO”保留态度的原因。OFC 上 Arista 的 Bechtolsheim 一句“英伟达在一边,其他所有人在另一边”说的就是这个分野。
量产口径要分辨:“宣布量产”“向精选伙伴出货”“工程样机”“放量”是四个不同的阶段;截至 2026 年 9 月,CPO 交换机处在“向精选伙伴出货、下半年扩产”的阶段,2027–2028 才是放量年。
4.4 两种 CPO:封在一起的是交换芯片,还是算力芯片
一句话:现在量产的 CPO 都是把交换芯片和硅光封在一起;把算力芯片(GPU/XPU)和硅光封在一起也叫 CPO,但那是 2028 年前后的事,业内常另起名叫“光 I/O”(OIO)。本文前面画的 CPO 截面(图 6)用的是交换芯片,就是因为今天能买到的只有这一类。

图 10 两种 CPO 的对照:左为交换侧 CPO(交换芯片 + 8/16 个光引擎),右为算力侧 CPO(GPU/XPU + HBM + 光 I/O 芯粒);下方为 NPO 的两种板级位置(绕交换芯片或绕 XPU)。

<点击图片可放大查看>
为什么先做交换芯片,不先做 GPU
交换芯片本质是“全 I/O”芯片:102.4T 等于 512 条 200G 电通道全部从封装里出去,每一条最终都要变成光,光引擎放进封装收益最大。
GPU 的封装已经被 HBM 占满,功耗 1000W 以上,再塞光引擎要和存储抢面积、抢散热,一颗三万美元级的芯片良率风险也更大。
GPU 的高速互连(NVLink)在机柜内用铜就够了,铜无源零功耗;只有 Scale-up 域超出一个机柜(NVL576、NVL1152)时,GPU 侧才有出光的必要。
英伟达路线图上要分清两步:Rubin Ultra NVL576(2027 下半年)的 CPO 装在 NVLink 交换芯片上,仍是交换侧;Counterpoint 的解读是到 Feynman 一代(2028)GPU 封装才集成硅光、采用 OCI 标准——这是第三方判断,英伟达没有明说。
NPO 的对应关系:NPO 是板级方案,光引擎可以放在交换芯片旁边,也可以放在加速卡上 XPU 旁边,所以阿里、腾讯说的“超节点 NPO”两种位置都可能出现。这也是中国云厂选 NPO 的一个隐含理由:不用等 GPU 厂商开放封装,就能在板上把光引擎往算力芯片挪。
五、
5.1 两把尺子:功耗与距离
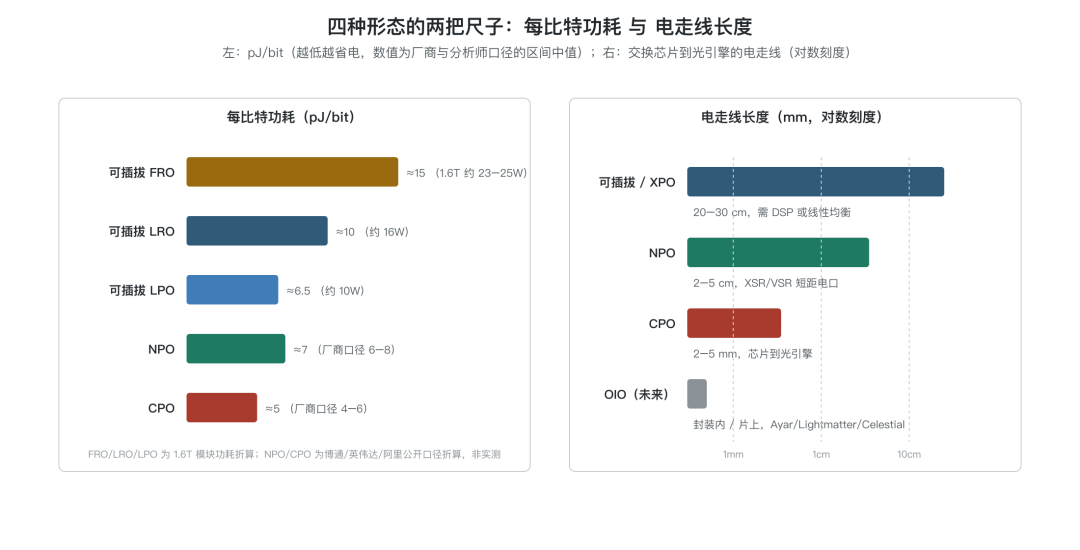
图 7 每比特功耗与电走线长度。可插拔 FRO 约 15 pJ/bit、LRO 约 10、LPO 约 6.5(按 1.6T 模块功耗折算);NPO 约 6–8、CPO 约 4–6(厂商口径折算)。电走线从 20–30 cm(可插拔)到 2–5 cm(NPO)到 2–5 mm(CPO)。
把两把尺子放在一起看,会发现 NPO 与 LPO 的功耗其实很接近——两者都去掉了 DSP。区别在于 LPO 的电走线仍有 20–30 cm,完全靠交换芯片的 SerDes 去补偿,互操作与故障归责难;NPO 把走线缩到 2–5 cm,主机侧的损耗预算从 20 多 dB 降到 10 dB 以内,线性直驱就变得“稳”了。换句话说,NPO 是把 LPO 做稳的办法,CPO 是把 NPO 再往前推一步。
5.2 各自的主场:Scale-out 与 Scale-up
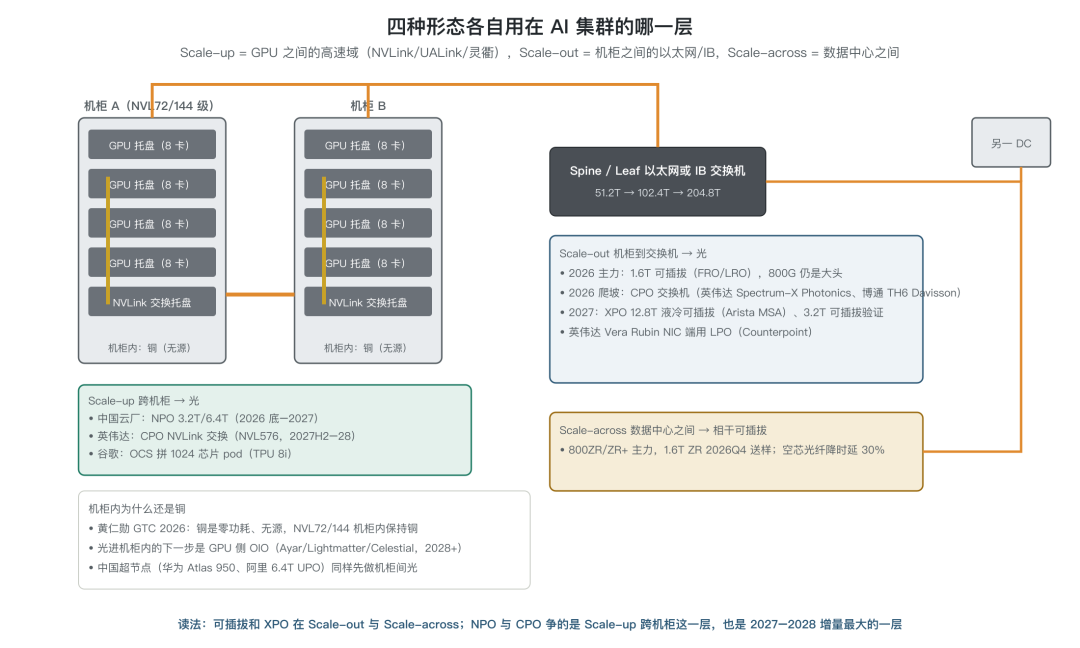
图 8 四种形态在 AI 集群里的位置:机柜内是铜,机柜到 Spine/Leaf 交换机(Scale-out)是可插拔与 CPO 交换机的主场,跨机柜的 GPU 高速域(Scale-up)是 NPO 与 CPO NVLink 交换争夺的层,数据中心之间(Scale-across)是相干可插拔。
Scale-out(机柜到交换机):2026 年的主力是 1.6T 可插拔,800G 仍是大头;CPO 交换机(英伟达 Spectrum-X Photonics、博通 TH6 Davisson)在这一层爬坡;2027 年 XPO 与 3.2T 可插拔进入。这一层的关键词是“密度”和“互操作”,可插拔的优势最大。
Scale-up 跨机柜(GPU 高速域):今天机柜内全是铜,跨机柜才用光。中国云厂走 NPO(阿里 3.2T NPO 2026 底小批量、6.4T UPO 2026 下半年调通),英伟达走 CPO NVLink 交换(NVL576 2027 下半年、Kyber 2028),谷歌走 OCS 拼 1024 芯片 pod。这一层 2027–2028 增量最大,也是 NPO 与 CPO 真正竞争的地方。
Scale-across(数据中心之间):相干可插拔 800ZR/ZR+,1.6T ZR 2026Q4 送样;与四种形态无关但共享 DSP 与激光器供应链。
机柜内:铜还会用很久,光进机柜内的下一步是 GPU 侧的 OIO(Ayar Labs、Lightmatter、Marvell 收购的 Celestial AI),时间在 2028 年以后。
5.3 NPO 与 CPO 不是替代,是分工
把三件事叠在一起看:(1)功耗上 CPO 比 NPO 再省 20–40%,但 NPO 已经拿到了去 DSP 的大头收益;(2)供应链上 CPO 绑定台积电先进封装与芯片厂生态,NPO 用主板 Socket 与 2.5D 封装、国内链条能参与;(3)时间上 3.2T NPO 2026 底就小批量,CPO 用于 Scale-up 要等 2027 下半年到 2028。所以 2026–2027 年中国云厂的 Scale-up 光互连以 NPO 为主,CPO 是英伟达/博通生态的事,两者在不同客户、不同层级同时推进。真正会决定 2028 年格局的两个变量是:400G/lane 一代 NPO 还能不能线性直驱,以及英伟达 NVLink CPO 能否按 2027H2 兑现。

<点击图片可放大查看>
六、

图 9 2025–2028 各形态的量产节奏(公开口径):深色 = 量产/规模部署,浅色 = 演示/验证/小批量。
光迅 11B53:6.4T NPO 光引擎(Socket + ELSFP + FMU-Shuffle)、3.2T 硅光 NPO、单波 400G Live Demo——问引擎接口是否对齐 OIF 12.8T 立项稿、ELSFP 波长数与单波功率、有没有客户样品项目。
华工正源 12A51:3.2T 实时演示(450G PAM4、3nm/2nm DSP)、6.4T NPO(802.3dj/CMIS 5.3、去 DSP、500m)、6.4T+ CPO/NPO 光引擎——问 3.2T 用的哪家 DSP 与调制器、有无眼图、NPO 与光迅是否互换。
新易盛 6B75:1.6T DR4(单波 400G)、6.4T NPO、12.8T XPO媒体口径——问 1.6T 月产能与硅光比例、XPO 实物与液冷方案。
ATOP 13A85:1.6T LRO 实时误码、3.2T NPO;Coherent / Marvell / Broadcom / Tower / Acacia 有固定会议室可约见。
论坛:9 月 9 日下午 10ABC 海思场(华为超节点、腾讯 NPO 部署);9 月 10 日上午 1C 400G per Lane MSA Draft 1.0 发布;9 月 10 日下午 10ABC NPO Summit(OIF 12.8T、阿里 NPX、华为、博通 VCSEL NPO、TE/安费诺/YAMAICHI 连接器)。
若您对硅光SiGe技术及流片相关话题有更多探讨需求,欢迎添加微信深入交流。

七、

<点击图片可放大查看>
八、
功耗:FRO/LRO/LPO 按 1.6T 模块公开功耗(23–25W / 约 16W / 约 10W)折算;NPO 按阿里“单位 bit 能耗降 50%”与厂商口径折算;CPO 按博通“较可插拔降 70%”、Meta 实测“省 65%”、英伟达“3.5–5 倍能效”折算。均非本报告实测。
距离:可插拔 20–30 cm、NPO 2–5 cm、CPO 2–5 mm 为业界通用量级,具体产品有差异。
时间点:阿里云陈钦(cioe.cn 嘉宾观点)、信通院刘璐(OIF 12.8T NPO 立项)、TrendForce 2026-07(Spectrum-X CPO 放量)、野村 2026-03(3.2T 商用时点)、XPO MSA、Cignal AI、英伟达 GTC 2026、SemiAnalysis(Kyber 延期)、光纤在线 2026-08-25 至 09-05 各展商预告。
本文与《2026 光博会(CIOE 2026)看点分析(260906)》共用事实底稿,相关来源清单见该报告第九节。
*免责声明:本文由作者原创。文章内容系作者个人观点,半导体行业观察转载仅为了传达一种不同的观点,不代表半导体行业观察对该观点赞同或支持,如果有任何异议,欢迎联系半导体行业观察。
END
今天是《半导体行业观察》为您分享的第4529期内容,欢迎关注。
推荐阅读
★
★
★
★
★
★
★
★
加星标⭐️第一时间看推送~