点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
一、VGGT的全局注意力:效果好,但代价高
VGGT和这类前馈式三维重建模型,正在把多视图几何推向一个统一的Transformer框架。它们用预训练的DINOv2编码每张图像,在聚合器中交替使用全局自注意力和帧自注意力,让不同视图的token彼此交换信息,从而同时预测相机位姿、深度、点图和跟踪结果。VGGT的消融实验曾明确指出,全局自注意力优于交叉注意力,而全局与帧注意力交替使用效果最好。这一设计后来被和MapAnything沿用。
但全局注意力有一个绕不开的代价:**对于帧输入,它的计算复杂度是**。当输入从10帧增加到100帧、300帧甚至800帧时,推理时间和显存占用迅速膨胀。已有的加速方案,例如FastVGGT和FasterVGGT,分别借用token合并和块稀疏注意力来降低成本,但它们大多缺少对VGGT完整前向过程的系统分析,也没有真正利用全局注意力“在做对齐”这一特性。

工作因此提出两个问题:交替注意力为什么有效? 以及 能否在不牺牲性能的前提下,大幅降低全局注意力的成本?
 图1左侧展示了AVGGT的加速流程和子采样全局注意力的直觉:全局注意力主要通过对齐不同视图中的空间对应区域来工作,因此只需要保留稀疏的Key/Value token,同时保留全部Query。右侧是7-Scenes数据集上密集设置(每段333帧)的相机位姿估计结果,AVGGT和A-在不同子采样因子下均能保持精度。
二、逐层拆解:早期层不干活,中间层做对齐,最后层只微调
工作没有直接套用现成的稀疏注意力,而是先对VGGT和的全局注意力层做了逐层分析。作者选取四个代表性全局层(第1、5、12、22层),对注意力头取平均,只保留patch token,从完整注意力矩阵中选出Top-50的注意力对,再把这些高权重连接画成箭头。
早期全局层(例如第1、5层) 的注意力分布相当均匀,Top激活值明显弱于中间层。更关键的是,这些高权重连接呈现出两种模式。第一种出现在最初一两层,最强匹配几乎总是连接具有相同坐标的token,说明此时注意力主要由位置嵌入驱动,而不是图像内容。第二种出现在其他早期层,Top条目反复关注一小群固定的key token。作者把所有输入图像旋转后,这些被高度关注的key会转移到其他token上,说明它们并不对应任何视图不变的三维结构。换句话说,早期全局层并没有在建立有意义的多视图对应。消融实验也支持这一点:把早期全局层直接替换为帧注意力,或者把它们的Key/Value替换为所有token的均值,精度几乎不变。
中间全局层(例如第12层) 的行为完全不同。注意力图变得稀疏,Top激活值急剧上升,选择性明显增强。高激活的token几乎只落在两类关系上:查询和key是同一个token(自patch),或者两个token对应不同视图中的同一空间位置。这两类关系都直接服务于三维一致性,说明中间全局层才是模型真正开始形成多视图对应的地方。
最后全局层 提供的只是微小精炼,而不是建立新的对应关系。把最后几层全局注意力替换为帧注意力,性能只出现轻微下降。
这个逐层分析给出了交替注意力的工作机制:全局注意力负责强制多视图一致性,帧注意力负责精炼单视图结构,二者交替形成迭代。而既然早期层不做对齐、最后层只做微调,真正需要全局计算的只有中间层,这就为加速提供了明确的手术位置。
 图2展示了四个代表性全局层的注意力分析:早期层(第1、5层)注意力分散,高权重连接受位置嵌入或固定key主导;中间层(第12层)注意力稀疏,高激活对应自patch或跨视图同位置;最后层只做微小精炼。
三、方法:两步无需训练加速,把全局注意力“拆开”再“采样”
基于上述分析,工作提出一个无需训练的两步加速方案,直接作用在已有的VGGT和权重上。
第一步:Global-to-Frame,把早期全局层换成帧注意力。 在原始VGGT中,帧注意力块之后的token布局是,进入全局注意力块之前会重排成,让所有帧联合计算注意力。工作的做法很直接:对于选定的早期全局层,跳过这次重排,保持逐帧布局,让注意力在每帧内部独立计算,其他组件和参数完全不变。这样,受影响块的计算量从降到。工作在VGGT上把前9个全局层(索引0到8)转换为帧注意力,在上转换前10个。
第二步:Subsampling Global Attention(SGA),对剩余全局层的Key/Value做子采样。 中间全局层的主要工作是跨视图对齐,而对齐并不需要所有patch token参与。工作从点云对齐的角度给出直觉:用刚性变换对齐两个点云,原则上只需要少量锚点,密集匹配是冗余的。于是,SGA保留全部Query和全部特殊token,只对patch token的Key/Value做均匀网格子采样。
具体来说,引入子采样因子,在的窗口内保留第一个patch token作为Key/Value。工作使用的映射是:对应,对应,对应,对应。对于VGGT,第一帧作为参考视图保持不压缩;对于,所有帧统一子采样。这样全局注意力的计算量大约降低倍。
增强版子采样:保留对角线,均值填充丢弃列。 既然高激活注意力要么是对角线自交互,要么是跨视图匹配,工作在基础子采样上进一步保留每个token的自注意力项(对角线),并用一个均值Key/Value对来近似所有被丢弃的列。注意力在三个不相交的部分上计算:保留的子集、对角线自项、以及代表所有丢弃patch的均值分量。三者共享同一个softmax归一化,因此权重是联合归一化的,不会产生冗余。这个增强只引入的额外开销,不影响整体加速。
 图3展示了子采样全局注意力的结构:行是Query,列是Key。对于patch token,每帧保留一个固定子集作为Key/Value(每个窗口一个patch,密度为),同时保留对角线自交互,并用一个均值分量近似所有被丢弃的列,所有部分共享softmax归一化。
四、实验:从10帧到800帧,全面提速且精度稳定
工作在VGGT和上分别实例化为AVGGT和A-,覆盖稀疏和密集两种多视图设置。
稀疏设置使用RealEstate10K(10帧)、TUM-dynamics(90帧)和DTU(10帧)。
表1 展示了RealEstate10K上的相机位姿估计结果。VGGT的AUC@30为88.130,AVGGT(4)为87.045,几乎持平;AVGGT(4)的推理时间为0.291秒,VGGT为0.307秒。FastVGGT由于引入额外计算,在短序列上反而更慢(0.735秒),FasterVGGT_75的AUC@30降到76.651。
表2 展示了TUM-dynamics上的结果。90帧序列上,VGGT耗时7.924秒,AVGGT(4)降到3.761秒,约2倍加速,ATE保持0.012。
表3 展示了DTU点图估计结果。AVGGT(4)的Acc.为1.193,VGGT为1.185,精度基本持平,时间从0.466秒降到0.428秒。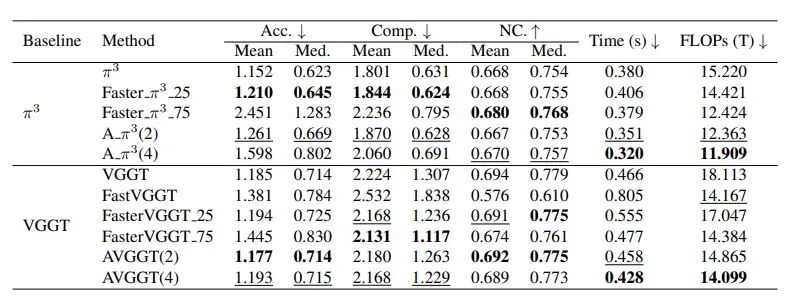
密集设置使用7-Scenes,每段333帧。表4显示,VGGT的AUC@30为77.755,AVGGT(4)为78.290,甚至略高;时间从79.945秒降到30.430秒。FasterVGGT_75虽然时间更短,但AUC@30只有70.074。也就是说,在密集视图下,AVGGT不仅加速,精度还略有提升。
极密集设置把每段扩展到800帧。表5 显示,原始耗时298.477秒,A-(9)降到30.273秒,接近10倍加速,AUC@30从80.572变为79.409,几乎不变;VGGT原始耗时397.133秒,AVGGT(9)降到50.034秒,约8倍加速,AUC@30从74.161变为77.382,反而更好。FasterVGGT和Faster-在800帧下直接OOM,无法运行。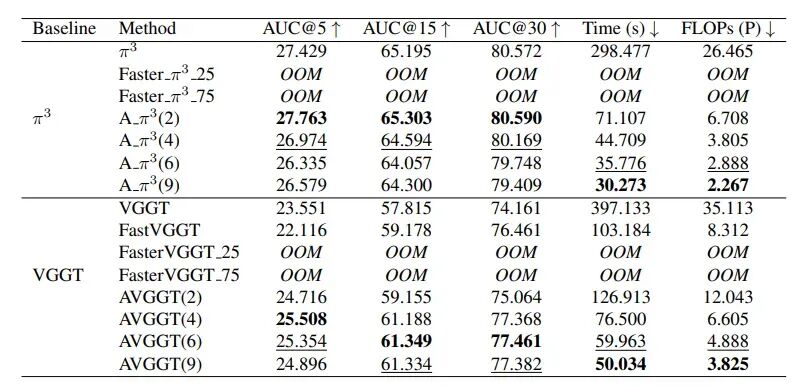
消融实验进一步验证了分析。表6 显示,把VGGT前9个全局层替换为帧注意力(VGGT(G2F)),AUC@30为87.981,原始VGGT为88.130,几乎无损;把早期Key/Value替换为均值(VGGT(G2M)),AUC@30为87.425,也接近原始。这说明早期全局层确实不承担多视图对齐。子采样因子从2增加到9,稀疏设置下精度逐渐下降,但密集设置下甚至优于原模型,进一步说明全局注意力主要做对齐,而密集重叠区域存在大量冗余。
 图4展示了RealEstate10K上选择的消融结果,工作选择以平衡性能与速度。
五、写在最后
AVGGT的核心贡献不在于提出新的网络结构,而在于用逐层分析回答了“全局注意力到底在做什么”,并据此设计了一个无需训练、即插即用的加速方案。早期全局层不做有意义的多视图对应,可以直接换成帧注意力;中间层做跨视图对齐,但对齐只需要稀疏的Key/Value锚点;最后层只做微调,保留即可。两步手术之后,800帧输入下VGGT和分别获得约8倍和10倍加速,精度匹配甚至略优。
工作最值得关注的数字是8-10倍和 。8-10倍是800帧下的推理加速比,而意味着全局注意力的Key/Value被压缩到原来的九分之一,在密集设置下精度仍未下降。这两个数字放在一起说明了一件事:长序列三维重建的全局注意力,大部分计算花在了冗余的密集匹配上。
从更宏观的视角看,AVGGT代表了一类新的加速思路:不是用更复杂的稀疏模式去近似全局注意力,而是先理解全局注意力在每一层实际承担的角色,再对不同的层做不同的事。早期层降级为帧注意力,中间层做锚点式对齐,最后层保留。这种“分层手术”的哲学,对于其他依赖全局注意力的长序列视觉模型,同样具有参考价值。
本文仅做学术分享,如有侵权,请联系删文。
。


扫码添加微信,备注:姓名+方向+单位,邀请入群。